Redis 高可用架构:主从、哨兵、集群与分片

主从、哨兵、集群与分片——高可用架构全解 一、问题切入:单机 Redis 能走多远 开发环境启动一个 Redis 实例,redis-cli 连上去,SET / GET 一切正常。然后某天线上出了问题: 促销活动期间,Redis 内存飙到 32GB 上限,新的写入被拒绝 服务器宕机,缓存全丢,所有请求直接穿透到 MySQL,服务雪崩 同一个 Key 被几百个并发请求同时修改,客户端频繁收到 READONLY 错误 这些问题指向同一个根因:单机 Redis 有三个硬伤。 硬伤 表现 后果 内存上限 一台机器最多几百 GB 内存,存不下全量数据 频繁淘汰 / OOM 单点故障 进程挂掉 → 整个缓存层不可用 请求穿透到 DB,服务雪崩 写吞吐瓶颈 单机只能处理几万 QPS 的写入,核心在主线程串行执行 促销期间扛不住 Redis 为了解决这三个问题,依次演进出了三种架构模式——主从复制、哨兵模式、集群模式。理解这三者之间的关系,是开发者对接云 Redis 服务的前提。 flowchart TD classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; S[📦 单机 Redis] --> M[📋 主从复制] M --> S2[🔍 哨兵模式] S2 --> C[🔗 集群模式] M --> M1["解决问题: 读扩展 + 数据冗余\n新增问题: 手动故障转移"] S2 --> S2A["解决问题: 自动故障转移\n新增问题: 写仍单点"] C --> C1["解决问题: 写扩展 + 海量数据\n新增问题: 跨槽限制"] class S,M,S2,C process; class M1,S2A,C1 highlight; class S startEnd; 这张演进路线图的含义:后一层架构不是替代前一层,而是叠加。集群模式内置了主从复制和哨兵的部分能力,但三者解决的问题域并不完全相同。下面逐一展开。 ...
一月 17, 2023 · 6 分钟 · 1251 字 · yaomingye

MySQL 实战优化:从 EXPLAIN 到 NULL 陷阱

从 EXPLAIN 到 NULL 陷阱——优化其实有章可循 📌 前置知识:这篇是系列最后一篇,面向日常开发的实战视角。前四篇的理论基础——B+树、索引结构、MVCC、锁机制——这篇会直接引用而不重复展开。建议至少读过第一篇 B+树索引体系再看这篇。 1. EXPLAIN:优化器的自白 EXPLAIN 是 SQL 优化的第一工具。它不会替你优化 SQL,但它告诉你 MySQL 打算怎么优化你的 SQL——用了哪个索引、扫描多少行、做了什么额外操作。理解了它的输出,慢查询的根因通常一目了然。 EXPLAIN SELECT * FROM users WHERE name = 'Zhang' AND age > 20 ORDER BY id; 输出如下(省略部分列): +----+------+---------------+------+---------+-------+------+-------------------+ | id | type | possible_keys | key | key_len | ref | rows | Extra | +----+------+---------------+------+---------+-------+------+-------------------+ | 1 | ref | idx_name | idx | 102 | const | 120 | Using index cond | +----+------+---------------+------+---------+-------+------+-------------------+ 逐字段解读: ...

十二月 31, 2022 · 6 分钟 · 1208 字 · yaomingye

MySQL 锁与日志系统:从并发控制到崩溃恢复

锁与日志:并发控制如何实现崩溃恢复 📌 前置知识:前三篇分别讲了 B+树索引、Join 原理、MVCC。这篇讲两个主题——锁(LBCC,基于锁的并发控制)和日志(Redo Log + Binlog)——它们分别在"正确性"和"持久性"上补足了 MVCC 的短板。MVCC 解决读-写冲突,锁解决写-写冲突;日志保证写入的数据断电不丢。 1. 锁的类型:InnoDB 到底有哪些锁 MVCC 让读者不需要锁就能看到一致的数据版本。但当两个事务同时修改同一行时,多版本帮不上忙——因为最终只能有一个版本成为"当前版本"。这就需要锁来协调写-写冲突。 InnoDB 的锁按粒度分为两级:表级锁和行级锁。 表级锁 锁类型 SQL 关键字 行为 表共享锁(S) LOCK TABLE t READ 自己可读不可写,其他人可读不可写 表排他锁(X) LOCK TABLE t WRITE 自己可读写,其他人连读都不行 意向共享锁(IS) 自动加 “我打算对其中某行加 S 锁”——在行上加 S 锁前必须先在表上加 IS 意向排他锁(IX) 自动加 “我打算对其中某行加 X 锁”——在行上加 X 锁前必须先在表上加 IX AUTO-INC 锁 自增列插入 插入自增主键时确保值连续递增 意向锁是 InnoDB 实现多粒度锁的关键。加行锁之前先加表级意向锁,这样其他事务要加表锁时只需检查表的意向锁就能知道该表是否有行锁,不需要逐行检查。比如事务 A 对某行加了 X 锁(先在表级加 IX 锁),事务 B 想 LOCK TABLE t WRITE(加表级 X 锁),B 一检查发现表上有 IX 锁,直接等待,不需要扫描所有的行。 ...

十二月 30, 2022 · 4 分钟 · 663 字 · yaomingye

MySQL 事务与 MVCC:多版本并发控制的完整原理

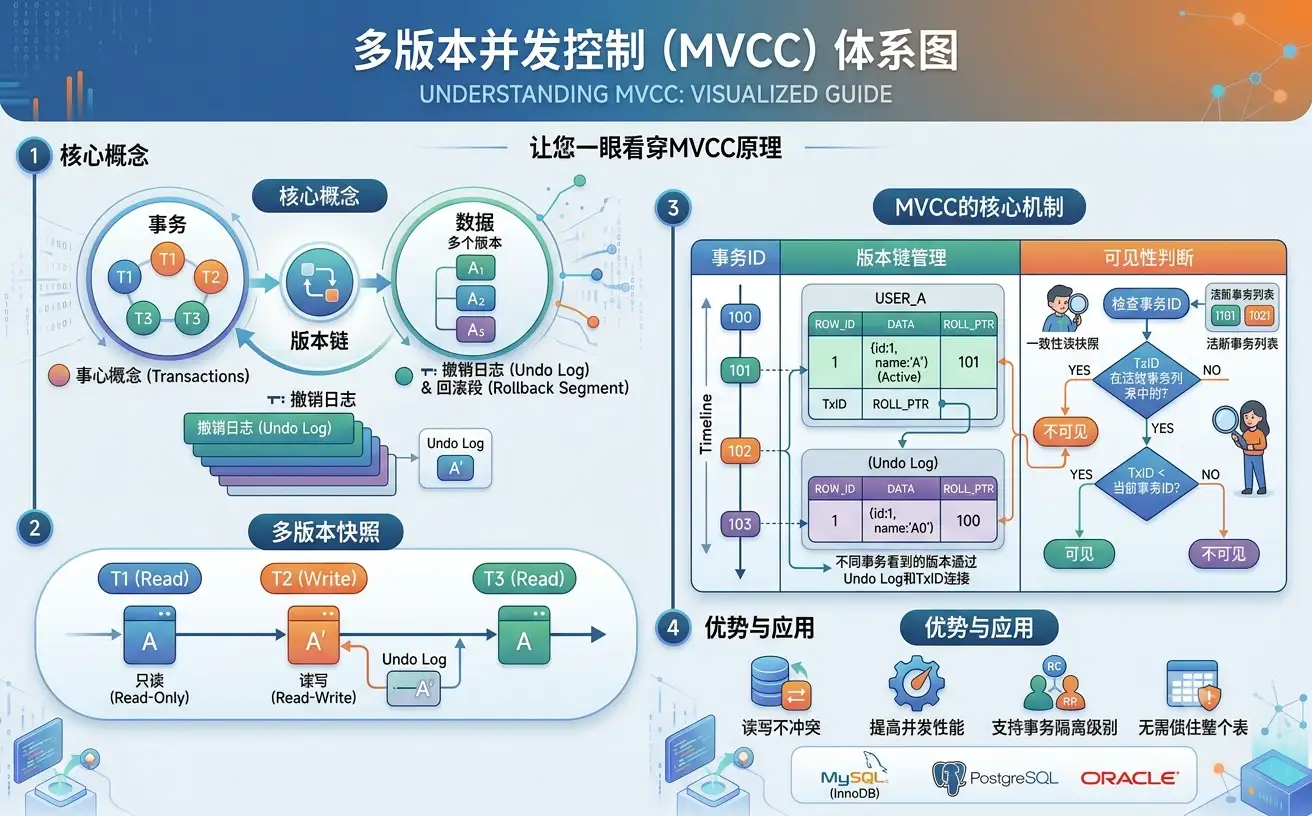
事务与 MVCC:多版本并发控制原理拆解 📌 前置知识:这篇需要理解前两篇的 B+树结构和聚簇索引。核心概念——隐藏列、Undo Log、ReadView——都是在 B+树的聚簇索引叶子页上工作的。建议读到这里时回想前文 InnoDB 页结构中 User Records 的记录头信息。 0. 60 秒速览:用一句话记住 MVCC 先别管术语,用一个生活场景建立直觉。 想象你正在写一份共享文档(Google Docs / 腾讯文档)。你打开它时,看到的是当时那个版本。别人在你之后改了几版,你不会突然看到"文档变了"——除非你刷新。你写的部分,别人在你保存前也看不到。 MySQL 的 MVCC 就是这个机制: 每次修改不覆盖原数据,而是生成一个新版本。读的人看到的是"自己开始读那一刻"的版本快照,写的人不影响正在读的人。 flowchart LR subgraph "同一行数据 (id=1, age=25)" V3["版本3 age=30DB_TRX_ID=300(当前行)"] V2["版本2 age=28DB_TRX_ID=200"] V1["版本1 age=25DB_TRX_ID=100(INSERT 原始版)"] end T1["事务A开始读"] -->|"ReadView 快照看到版本1"| V1 T2["事务B修改两次"] --> V2 T2 --> V3 V3 -.->|"DB_ROLL_PTR回滚指针"| V2 V2 -.->|"DB_ROLL_PTR"| V1 classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb; classDef root fill:#0f172a,stroke:#3b82f6,stroke-width:2.5px,color:#bfdbfe,font-weight:bold; class V1,V2,V3 data; class T1,T2 root; 这张图里有 MVCC 的全部核心零件,读完这篇你会逐个认识它们: ...

十二月 29, 2022 · 7 分钟 · 1350 字 · yaomingye

MySQL Join 原理:B+树上的表连接

B+树上的表连接——彻底搞懂 Join 📌 前置知识:这篇基于前一篇 B+树索引体系的内容。默认读者已经理解聚簇索引、二级索引、回表、B+树叶子链表这几个概念。这不会是一篇"查字典"式的 SQL 语法说明,而是从 InnoDB 引擎视角解释 Join 到底在干什么。 1. Join 的本质:笛卡尔积的引擎视角 从数学上讲,Join 是两张表的 笛卡尔积 + 过滤条件: SELECT * FROM A JOIN B ON A.id = B.a_id WHERE A.age > 20; 逻辑上等价于:先穷举 A × B 的所有组合(笛卡尔积),再保留满足 A.id = B.a_id AND A.age > 20 的行。但现实中没有引擎会真去算笛卡尔积——100 万 × 100 万 = 1 万亿行,物理世界做不到。 MySQL 实际的做法是:选一张表做驱动(外层循环),另一张做被驱动(内层查找),逐行匹配。算法的核心差异在于"如何查找被驱动表中匹配的行"——这才有了 SNLJ、BNLJ、INLJ、Hash Join 四种策略。 flowchart TD DRIVER["🔁 驱动表(外层)逐行读取"] --> CHECK{"被驱动表\n有可用索引?"} CHECK -->|"有"| INLJ["Index Nested-Loop\n每行走 B+树查找"] CHECK -->|"无"| BNLJ["Block Nested-Loop\nJoin Buffer 批量匹配"] BNLJ --> HASHCHECK{"MySQL 8.0+\n且等值连接?"} HASHCHECK -->|"是"| HJ["Hash Join\n构建哈希表替代 B+树"] HASHCHECK -->|"否"| BNLJ2["仍用 BNLJ 或 SNLJ"] classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:1.5px,color:#ede9fe,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; class DRIVER startEnd class CHECK,HASHCHECK condition class INLJ,BNLJ,HJ highlight class BNLJ2 process 这四种算法,接下来逐个拆解。 ...

十二月 28, 2022 · 4 分钟 · 699 字 · yaomingye

MySQL B+树索引体系

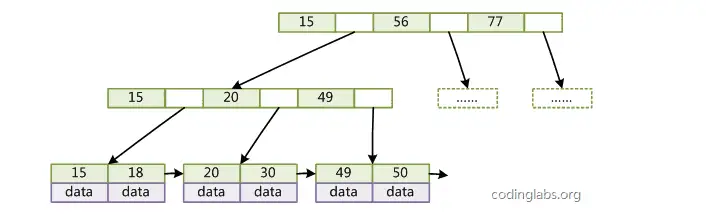
MySQL B+树索引体系:从数据结构到查询执行 📌 前置知识:读者需了解磁盘与内存的速度差异(磁盘寻道 ~ 10ms,内存访问 ~ 100ns),以及基本的数据结构概念(链表、树、二分查找)。本文所有讨论基于 InnoDB 存储引擎。 1. 为什么是 B+树 MySQL 的数据是存在磁盘上的。磁盘 IO 的速度比内存慢约 10 万倍,所以数据库设计的第一原则是:尽量减少磁盘 IO 次数。 要理解为什么用 B+树,先看二叉搜索树(BST,Binary Search Tree)。 在 BST 中,每个节点只存一个键,每层只有两个子节点。如果数据量是 100 万行,树高就是 log₂(1000000) ≈ 20 层。执行一次查找最多需要 20 次磁盘 IO——因为每一层的节点都可能分散在不同的磁盘页上,每次读一个节点就是一次磁盘 IO。 这个代价太高了。解决的思路是:让每个节点存更多的键,增加每层的分叉数,降低树的高度。 flowchart LR root1["🌳 二叉树 ⚡20层 IO 100万数据"] --> root2["🌲 多路查找树 ⚡3 ~ 4层 IO 100万数据"] root2 --> leaf["叶子链表 范围扫描"] classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef leaf fill:#052e16,stroke:#16a34a,stroke-width:1.5px,color:#bbf7d0,font-weight:bold; class root1,root2 startEnd class leaf leaf 从二叉树到 B+树的演进: ...

十二月 27, 2022 · 7 分钟 · 1315 字 · yaomingye

MongoDB 索引、事务与性能调优

生产落地的三件套:索引、事务与调优 📖 前置阅读:本文是 MongoDB 系列的生产调优篇,假设读者已经掌握了 MongoDB 文档模型、SpringBoot 操作和聚合管道。如果还没有,建议先阅读前三篇: MongoDB 核心概念:文档模型、BSON 与查询操作符全解析 —— 介绍篇 SpringBoot MongoDB 全操作指南 —— 实战篇 MongoDB 聚合管道深入 —— 进阶篇 一、⚡ 问题切入:查询怎么越来越慢了? 用户表单数据从 10 万增长到 500 万,“按手机号查询表单记录"从 5ms 变成了 800ms。你用 explain() 一看——stage: "COLLSCAN",全表扫描。 这场景和 MySQL 一样——数据量大了没建索引,写什么数据库都快不了。但 MongoDB 的索引有一些 MySQL 没有的类型,还有 Schema 设计的决策(嵌入还是引用?要不要用事务?)直接影响性能。 本篇要解决的问题:怎么设计索引、怎么看懂 explain、怎么选嵌入还是引用、什么时候用事务——以及遇到性能问题时从哪下手排查。 二、📊 索引类型与策略 2.1 单字段索引与复合索引 底子和 MySQL 一样——B-Tree。创建一个索引语法几乎一样: // 单字段索引 db.users.createIndex({ email: 1 }) // 1 = 升序,-1 = 降序(单字段索引中不重要) // 复合索引(多个字段组合) db.orders.createIndex({ userId: 1, createTime: -1 }) // 查看所有索引 db.orders.getIndexes() 复合索引的 ESR 规则——这是 MongoDB 复合索引最重要的设计原则: ...

十月 29, 2022 · 6 分钟 · 1237 字 · yaomingye

MongoDB 聚合管道深入

聚合管道实战:从入门到精通 📖 前置阅读:本文是 MongoDB 系列的进阶篇,假设读者已经掌握了 MongoDB 文档模型和 SpringBoot 基本操作。如果还没有,建议先阅读前两篇: MongoDB 核心概念:文档模型、BSON 与查询操作符全解析 —— 介绍篇 SpringBoot MongoDB 全操作指南 —— 实战篇 一、⚡ 问题切入:查询能查出结果,但分析不出来 先看一个业务需求。你有一个电商订单 Collection: // 一条订单文档 { _id: ObjectId("..."), userId: 1001, total: NumberDecimal("6999.00"), status: "paid", items: [ { productName: "华为Mate60 Pro", category: "手机", price: NumberDecimal("6999.00"), quantity: 1 } ], createTime: ISODate("2024-01-15T10:30:00Z") } 产品经理要你给出以下数据: 每个用户的总消费金额 每月订单量趋势 销量最高的 10 个商品分类 每个用户的平均客单价 哪些商品经常一起购买(关联分析) 用 find 可以查出原始数据,但统计计算全得拉到 Java 内存里自己算——5 万条订单光加载到内存就需要 2 秒,再算就 5 秒起步。 这就是聚合管道的用武之地——把计算下推到 MongoDB 服务器端完成,只返回结果,不传原始数据。 二、🧱 聚合管道是什么 2.1 核心概念 聚合管道(Aggregation Pipeline) 是一组按顺序执行的数据处理阶段(Stage)。每个 Stage 接收上一阶段的输出,做一次数据变换,把结果传给下一阶段。 flowchart LR classDef stage fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; classDef data fill:#052e16,stroke:#16a34a,stroke-width:1.5px,color:#bbf7d0,font-weight:bold; classDef result fill:#0f172a,stroke:#3b82f6,stroke-width:2px,color:#bfdbfe,font-weight:bold; COLLECTION[(orders\n50000 文档)] COLLECTION --> S1[$match\n过滤: status=paid] S1 --> S2[$group\n分组: 按 userId] S2 --> S3[$sort\n排序: 总金额降序] S3 --> S4[$limit\n取前 10] S4 --> RESULT([10 条聚合结果]) class S1,S2,S3,S4 stage; class COLLECTION data; class RESULT result; 关键点: ...

十月 28, 2022 · 8 分钟 · 1662 字 · yaomingye

SpringBoot MongoDB 全操作指南

SpringBoot 集成 MongoDB:CRUD 到聚合全操作 📖 前置阅读:本文假设读者已了解 MongoDB 的文档模型、BSON 数据类型和 mongosh 基础操作。如果还不熟悉,建议先阅读 MongoDB 核心概念:文档模型、BSON 与查询操作符全解析。 本文按照"先搞懂操作 → 教程版完整实现 → 生产版架构模式 → 验证排错“的顺序组织。如果你只想快速上手 MongoTemplate 的 CRUD,读完 Part 1 后直接看 Part 2 即可;如果你想理解真实项目中 MongoDB 是怎么用的,需要完整读完。 Part 1:先搞懂要做什么 一、目标说明 这篇文章的目标:让读者在一篇文章内学会 SpringBoot 项目中所有常用的 MongoDB 操作,读完就能直接写到项目里。 具体来说,读完这篇文章会掌握: 用 @Document / @Id / @Field 注解定义 MongoDB 文档映射 用 MongoTemplate 执行 CRUD、复杂查询、更新操作 用 MongoRepository 做声明式查询(方法命名 + @Query) 聚合管道的 Java 写法初探 一个完整的"用户自定义表单"功能从零到一的实现 二、前置条件 前置项 具体要求 验证命令 JDK 17+(文中用 17,8+ 均兼容) java -version Maven 3.6+ mvn -v SpringBoot 3.x(文中用 3.2.0) mvn dependency:tree | grep spring-boot MongoDB 7.0(6.x 也兼容文中所有操作) mongosh --eval "db.version()" 前置知识 SpringBoot 基础、MongoDB 核心概念(第一篇) — Part 2:教程版 —— 从零掌握 MongoDB 全部操作 下面每一节都给出了完整的、可运行的代码。整个教程版使用同一个技术栈:Spring Boot 3.x + spring-boot-starter-data-mongodb,所有操作通过 MongoTemplate 和 MongoRepository 完成。 ...

十月 27, 2022 · 11 分钟 · 2206 字 · yaomingye

MongoDB 核心概念

MongoDB 核心概念:文档模型、BSON 与查询操作符全解析 一、⚡ 问题切入:MySQL 为什么不适合这个场景? 先看一个典型的系统设计需求。你正在开发一个 SaaS 平台的"用户自定义表单"功能——每个客户可以自己创建表单,定义不同的字段: 客户A:报名表 → 姓名、手机号、紧急联系人姓名、紧急联系人电话、是否过敏(是/否) 客户B:问卷表 → 昵称、年龄、兴趣爱好(多选)、详细简历(文本)、作品链接 客户C:订单表 → 商品名、单价、数量、收货地址(省/市/区/详细)、发票抬头、纳税人识别号 用 MySQL 做这件事,摆在面前的有三条路: 方案一:一张宽表 CREATE TABLE form_data ( id BIGINT PRIMARY KEY, field_1 VARCHAR(200), -- 姓名/昵称/商品名 field_2 VARCHAR(200), -- 手机号/年龄/单价 field_3 VARCHAR(200), -- 紧急联系人/兴趣爱好/数量 -- ... 预留 50 个字段 field_50 VARCHAR(200) ); 客户A的"紧急联系人电话"存在 field_4,客户B的"作品链接"存在 field_5,客户C的"纳税人识别号"存在 field_7。字段名没有任何业务含义,查询时只能对着文档翻"field_4 到底存了什么"。SQL 写成: SELECT * FROM form_data WHERE field_1 = '张三' AND field_2 = '13800000000'; 这已经不是在写代码了,是在玩解谜游戏。 ...

十月 26, 2022 · 8 分钟 · 1575 字 · yaomingye
Cat Radio