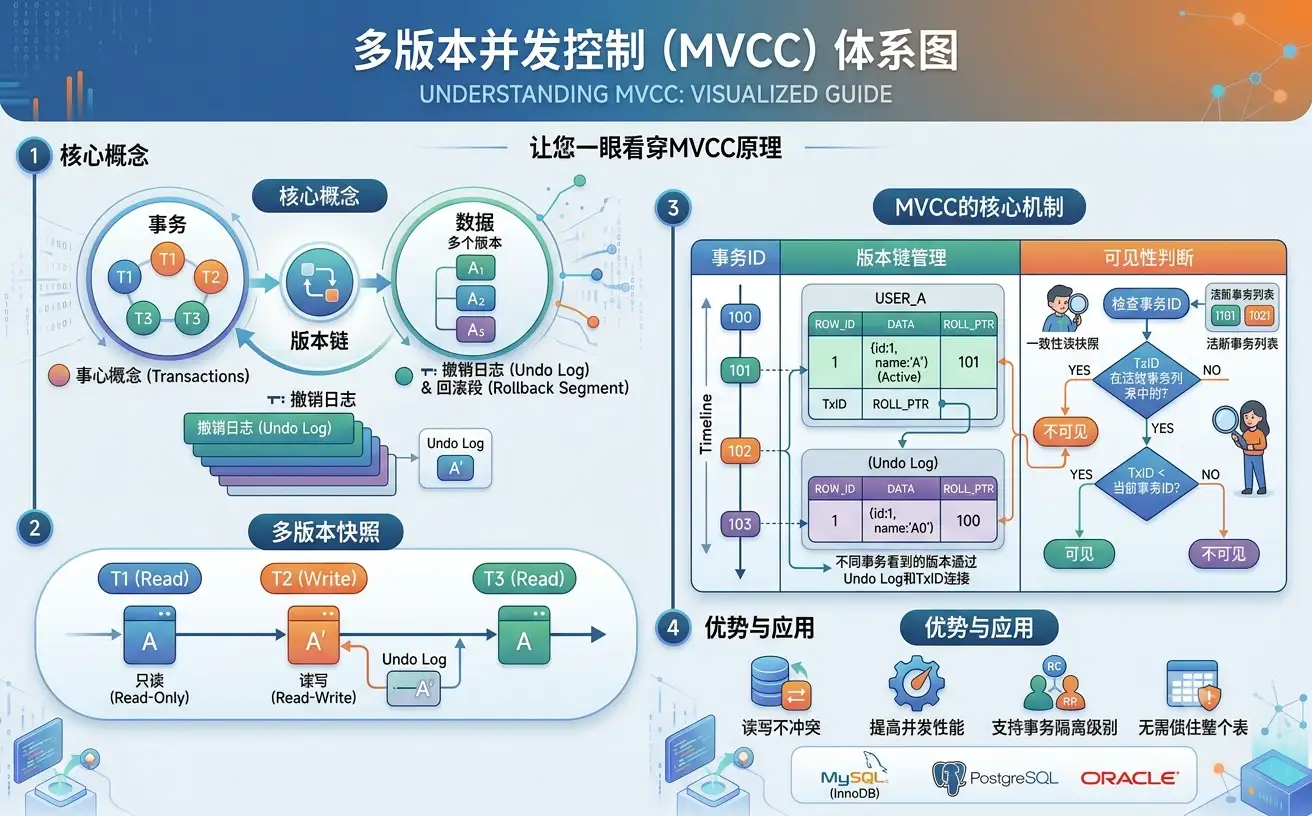
事务与 MVCC:多版本并发控制原理拆解
📌 前置知识:这篇需要理解前两篇的 B+树结构和聚簇索引。核心概念——隐藏列、Undo Log、ReadView——都是在 B+树的聚簇索引叶子页上工作的。建议读到这里时回想前文 InnoDB 页结构中 User Records 的记录头信息。
0. 60 秒速览:用一句话记住 MVCC
先别管术语,用一个生活场景建立直觉。
想象你正在写一份共享文档(Google Docs / 腾讯文档)。你打开它时,看到的是当时那个版本。别人在你之后改了几版,你不会突然看到"文档变了"——除非你刷新。你写的部分,别人在你保存前也看不到。
MySQL 的 MVCC 就是这个机制:
每次修改不覆盖原数据,而是生成一个新版本。读的人看到的是"自己开始读那一刻"的版本快照,写的人不影响正在读的人。
flowchart LR
    subgraph "同一行数据 (id=1, age=25)"
        V3["版本3 age=30
DB_TRX_ID=300
(当前行)"]
        V2["版本2 age=28
DB_TRX_ID=200"]
        V1["版本1 age=25
DB_TRX_ID=100
(INSERT 原始版)"]
    end
    T1["事务A
开始读"] -->|"ReadView 快照
看到版本1"| V1
    T2["事务B
修改两次"] --> V2
    T2 --> V3
    V3 -.->|"DB_ROLL_PTR
回滚指针"| V2
    V2 -.->|"DB_ROLL_PTR"| V1

    classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold;
    classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb;
    classDef root fill:#0f172a,stroke:#3b82f6,stroke-width:2.5px,color:#bfdbfe,font-weight:bold;
    class V1,V2,V3 data;
    class T1,T2 root;
这张图里有 MVCC 的全部核心零件,读完这篇你会逐个认识它们:
| 零件 | 一句话作用 | 本篇小节 |
|---|---|---|
| 隐藏列(DB_TRX_ID / DB_ROLL_PTR) | 每行记录"谁改的"+“旧版本在哪” | §3 |
| Undo Log | 旧版本存在哪,串成版本链 | §4 |
| ReadView | 读的时候"冻结"一份快照,判断哪个版本可见 | §5 |
| 版本链遍历 | 从最新版本往回找"自己该看到的版本" | §6 |
💡 忘记 MVCC 八股文的人,记住上面这张图就够了:一行数据有多个版本,读的人按快照挑版本,写的人只追加新版本。剩下的是细节。
1. 四种事务隔离级别:MySQL 到底在"隔离"什么
事务隔离级别解决的是 并发事务同时读写同一行数据 时的可见性问题。如果只有一个连接在操作数据库,根本不需要隔离级别——但现实的线上系统有几十上百个并发连接,读写冲突无处不在。
隔离级别定义了 一个事务能看到其他并发事务的哪些修改。SQL 标准定义了四种级别,从宽松到严格:
flowchart LR
    RU["🔓 READ UNCOMMITTED\n(读未提交)"] --> RC["🔒 READ COMMITTED\n(读已提交)"]
    RC --> RR["🔐 REPEATABLE READ\n(可重复读)"]
    RR --> SR["🔑 SERIALIZABLE\n(串行化)"]
    RU_label["脏读❌ 不可重复读❌ 幻读❌"] -.-> RU
    RC_label["不可重复读❌ 幻读❌"] -.-> RC
    RR_label["幻读⚠(部分解决)"] -.-> RR
    SR_label["全部解决✅"] -.-> SR

classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold;
classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb;
classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold;
classDef data fill:#052e16,stroke:#16a34a,stroke-width:1.5px,color:#bbf7d0,font-weight:bold;

    class RU startEnd
    class RC process
    class RR highlight
    class SR data
| 隔离级别 | 脏读 (Dirty Read) | 不可重复读 (Non-Repeatable Read) | 幻读 (Phantom Read) |
|---|---|---|---|
| READ UNCOMMITTED | ✅ 可能 | ✅ 可能 | ✅ 可能 |
| READ COMMITTED (RC) | ❌ 不会 | ✅ 可能 | ✅ 可能 |
| REPEATABLE READ (RR) | ❌ 不会 | ❌ 不会 | ⚠ 部分避免 |
| SERIALIZABLE | ❌ 不会 | ❌ 不会 | ❌ 不会 |
三种并发问题的定义:
脏读(Dirty Read):读到其他事务 未提交 的修改。事务 A 修改某行但未提交,事务 B 读到了这个未提交的值——如果事务 A 回滚了,事务 B 读到的数据就是"脏"的、从来没有真正存在过的。
不可重复读(Non-Repeatable Read):同一个事务内,同一条记录的两次读取结果不一致。事务 A 读某行(age=25),事务 B 修改该行并提交(age=30),事务 A 再读同一条(age=30)。两次读的版本不一样。
幻读(Phantom Read):同一个事务内,同一条查询的两次执行结果集行数不同。事务 A 查询 WHERE age > 20 (返回 10 行),事务 B 插入一行 age=30 并提交,事务 A 再查 WHERE age > 20 (返回 11 行)。数据"多出来了",像幻象一样。
⚠️ 新手提示:不可重复读和幻读很多人区分不清楚。区分的关键是——不可重复读是 同一条记录的内容变了(UPDATE 导致),幻读是 结果集的行数变了(INSERT/DELETE 导致)。MVCC 的 ReadView 机制在 RR 下能解决不可重复读,但幻读需要 Next-Key Lock 配合才能彻底解决——这是下篇的锁机制要讲的。
1.1 用实际 SQL 演一遍:三种并发问题到底长什么样
光看定义容易晕,直接看两个事务交错执行会"看见"什么。假设有一张表 user(id, name, age),初始数据 id=1, name='张三', age=25 :
场景一:脏读(READ UNCOMMITTED 下发生)
| 时刻 | 事务 A | 事务 B | A 看到什么 |
|---|---|---|---|
| t1 | BEGIN | ||
| t2 | BEGIN | ||
| t3 | UPDATE user SET age=30 WHERE id=1 (未提交) | ||
| t4 | SELECT age FROM user WHERE id=1 | 30(B 还没提交!) | |
| t5 | ROLLBACK (回滚了) | ||
| t6 | SELECT age FROM user WHERE id=1 | 25(B 回滚后) |
A 在 t4 读到的 30,是 B 从未真正提交的值——B 回滚后这个 30 就像没存在过。读到没提交的数据 = 脏读。
场景二:不可重复读(READ COMMITTED 下发生)
| 时刻 | 事务 A | 事务 B | A 看到什么 |
|---|---|---|---|
| t1 | BEGIN | ||
| t2 | SELECT age FROM user WHERE id=1 | 25 | |
| t3 | BEGIN | ||
| t4 | UPDATE user SET age=30 WHERE id=1 (提交) | ||
| t5 | SELECT age FROM user WHERE id=1 | 30(同一条记录变了!) |
同一个事务 A 里,同一条记录两次读到不同值(25 → 30)。同一条记录内容变了 = 不可重复读。
场景三:幻读(REPEATABLE READ 下仍可能发生)
| 时刻 | 事务 A | 事务 B | A 看到什么 |
|---|---|---|---|
| t1 | BEGIN | ||
| t2 | SELECT COUNT(*) FROM user WHERE age > 20 | 1 | |
| t3 | BEGIN | ||
| t4 | INSERT INTO user VALUES(2, '李四', 30)(提交) | ||
| t5 | SELECT COUNT(*) FROM user WHERE age > 20 | 2(多出一行!) |
同一个事务 A 里,同一条查询两次返回不同行数(1 → 2)。结果集行数变了 = 幻读。
💡 记不住三个名字?脏读 = 读了没提交的;不可重复读 = 同一条记录内容变了;幻读 = 结果集多出/少了行。前两个是"值的问题",幻读是"行数的问题"。
MySQL InnoDB 的默认隔离级别是 REPEATABLE READ。这个选择背后就是 MVCC 的设计——让 RR 在性能和一致性之间找到平衡。
2. MVCC 是什么:为什么要维护多个版本
MVCC(Multi-Version Concurrency Control,多版本并发控制)的核心思想一句话就能说清楚:读不阻塞写,写不阻塞读。
在传统的锁并发控制(LBCC,Lock-Based Concurrency Control)中,要读一行数据需要加共享锁,要写一行需要加排他锁。读写冲突时,要么读在等写锁释放,要么写在等读锁释放——吞吐量被锁等待吃掉。
MVCC 的做法是:每次修改不覆盖原数据,而是生成一个新版本。读操作根据事务开始的时间,选择一个"应该看到"的版本,不需要加锁;写操作创建新版本后旧版本仍然保留,不影响正在进行的读。这样读写分离、互不阻塞。
把两种方案放在一起对比,原理立刻清晰:
flowchart LR
    subgraph LBCC["❌ 传统锁并发控制(LBCC)
读写互斥,排队等待"]
        direction TB
        R1["事务 B 要读
age=25"] -->|"加共享锁"| W1["事务 A 持有排他锁
正在写 age=30"]
        W1 -->|"锁冲突!
B 必须等 A 提交"| Q1["⏳ B 阻塞等待"]
    end

    subgraph MVCC["✅ 多版本并发控制(MVCC)
读写并行,互不干扰"]
        direction TB
        R2["事务 B 要读
age=25"] -->|"无需加锁
直接读旧版本"| V2["版本链上的 age=25
(Undo Log 中的旧版本)"]
        W2["事务 A 正在写
age=30"] -->|"生成新版本
不覆盖旧数据"| V3["数据页新版本 age=30"]
    end

    classDef reject fill:#450a0a,stroke:#dc2626,stroke-width:2px,color:#fecaca,font-weight:bold;
    classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold;
    classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb;
    class R1,W1,Q1 process;
    class R2,W2 process;
    class V2,V3 data;
💡 左边是"一把锁管读写"——同一时刻只有一个人能碰这行数据;右边是"写的人造新版本,读的人看旧版本"——两个人各干各的,谁也不等谁。这就是 MVCC 为什么能提升并发吞吐的本质:把"读写互斥"变成"读写并行"。
MVCC 的"多版本"体现在 InnoDB 维护了三个机制:
- 隐藏列:每行数据有两个隐藏字段,记录最后一次修改的事务 ID 和指向旧版本的回滚指针
- Undo Log(回滚日志):旧版本数据存在 Undo Log 中,通过回滚指针串联成版本链
- ReadView(读视图):读操作创建一个"快照",记录当前活跃事务的集合。用这个快照判断版本链上的每个版本是否可见
接下来的三节逐个拆解这三个机制。
3. 隐藏列:每行数据自带的三个隐藏字段
InnoDB 在用户的每一行数据后面偷偷加了三个隐藏字段。建表时看不到它们,但它们真实地存在 16KB 页的 User Records 区域里。
DB_TRX_ID 和 DB_ROLL_PTR 是 MVCC 的物理基础:
- DB_TRX_ID:每个事务有全局唯一的递增 ID。修改一行时,把当前事务的 ID 写入本行的 DB_TRX_ID 字段。读操作通过比较这个 ID 和 ReadView 中的活跃事务列表,判断该版本是否可见。
- DB_ROLL_PTR:指向 Undo Log 中的旧版本。如果一行被更新了 5 次,就有 5 个版本通过 5 个回滚指针串联成版本链。
4. Undo Log:版本链是怎么串起来的
Undo Log 不只是一串"旧值"的集合——不同类型的操作产生不同类型和不同用途的 Undo 日志。
INSERT 操作:因为插入的行对其他事务不可见(在插入事务提交之前),所以 INSERT Undo Log 只需记录插入行的主键值。事务提交后,INSERT Undo Log 立即可以被回收。
UPDATE 操作(分两种情况):
- 不更新主键:UPDATE Undo Log 记录被修改列的 旧值。把当前行的 DB_TRX_ID 备份到 Undo Log,再把新的 DB_TRX_ID 写入行。同时将 DB_ROLL_PTR 指向刚写入的 Undo Log。
- 更新了主键:等同于 DELETE(对旧主键行打 delete_flag)+ INSERT(新主键行)。
DELETE 操作(分两个阶段):
- 阶段一 delete mark:只打
delete_flag = 1,不物理删除。记录 DELETE Undo Log。 - 阶段二 purge:Purge 线程负责物理删除。条件是 undo log 对应的旧版本 不再被任何 ReadView 需要。
下面用 HTML+CSS 展示一个更新操作形成的版本链:
DB_TRX_ID = 300 | DB_ROLL_PTR ──→ Undo Log #2
id=42 name='Charlie' age=28
DB_TRX_ID = 200 | DB_ROLL_PTR ──→ Undo Log #1
旧值:name='Bob' age=25
DB_TRX_ID = 100 | DB_ROLL_PTR ──→ Undo Log #0
旧值:name='Alice' age=22
DB_TRX_ID = 100 | DB_ROLL_PTR = NULL(链尾)
这是插入该行的原始版本
版本链的关键特征:
- 链尾始终是 INSERT Undo Log——这是该行的"出生证明"。之前的版本不存在。
- PURGE 线程定期清理不再被任何 ReadView 需要的旧版本。如果某条 Undo Log 的 DB_TRX_ID 比所有活跃事务的 ID 都小(说明所有事务都能看到更新版本),这个 Undo Log 就安全了,可以被清理。
- 长事务会阻止 Undo Log 清理。如果一个事务运行了很久,它的 ReadView 还是旧的——活跃事务 ID 列表里包含很多已经提交的事务。这些"已经提交但 ReadView 认为还不该看到"的事务产生的 Undo Log 不会清理,导致 Undo Log 膨胀。
4.1 Undo Log / Redo Log / Binlog:三个日志各管一件事
说到 Undo Log,很多人会把它和 Redo Log、Binlog 搞混——面试八股文里"日志三兄弟"经常一起考。先把三者分工用一张图钉死:
flowchart TB
    subgraph "事务执行一条 UPDATE"
        S["修改数据页"] --> U["写 Undo Log
记录旧值"]
        S --> R["写 Redo Log
记录物理修改"]
        S --> B["写 Binlog
记录逻辑操作"]
    end

    U -->|"作用1: 回滚
事务失败时撤销"| U1["ROLLBACK 恢复旧值"]
    U -->|"作用2: 版本链
MVCC 读历史版本"| U2["配合 DB_ROLL_PTR
构建多版本"]
    R -->|"作用: 崩溃恢复
断电后重放已提交修改"| R1["WAL + Checkpoint"]
    B -->|"作用: 主从复制
从库重放达到一致"| B1["ROW / STATEMENT / MIXED"]

    classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold;
    classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb;
    classDef root fill:#0f172a,stroke:#3b82f6,stroke-width:2.5px,color:#bfdbfe,font-weight:bold;
    class S root;
    class U,R,B process;
    class U1,U2,R1,B1 data;
| 日志 | 属于哪层 | 记录什么 | 核心用途 | 能不能删 |
|---|---|---|---|---|
| Undo Log | InnoDB 存储引擎层 | 修改前的旧值(逻辑) | ① 回滚未提交事务 ② MVCC 版本链 | 事务提交后慢慢清 |
| Redo Log | InnoDB 存储引擎层 | 修改后的物理页变化 | 崩溃恢复(重放已提交修改) | 循环写,Checkpoint 后覆盖 |
| Binlog | MySQL Server 层 | 修改的逻辑操作 | 主从复制 + 时间点恢复 | 按保留期归档 |
怎么记住三者的区别:
- Undo = 后悔药:改错了能回退(回滚 + 提供旧版本给 MVCC 读)
- Redo = 保险单:断电了数据不丢(崩溃后重放)
- Binlog = 录像带:记录整个操作过程,给从库"重播"(复制)
📌 面试最爱问的"两阶段提交"(Redo 和 Binlog 怎么保持一致)和"崩溃恢复流程"(Redo 重放 + Undo 回滚),在系列下一篇《MySQL 锁与日志系统》里有完整拆解。这篇只需要记住:MVCC 只用到 Undo Log;Redo 和 Binlog 是保证"持久性"和"复制"的另外两条线,和 MVCC 的"可见性"各管各的。
5. ReadView:那一刻"谁在跑"决定了你能看到什么
ReadView 的核心数据结构简单但精妙。它是一个 事务在读取数据时创建的快照,记录了那一时刻"谁还在跑"。
创建该 ReadView 的事务 ID。判断可见性时:DB_TRX_ID == creator_trx_id → 自己修改的 → 始终可见
创建 ReadView 时,系统中 所有活跃事务(未提交) 的 ID 列表。如 [101, 105, 108, 112]——这四个事务还没 COMMIT,它们的修改当前不可见
trx_ids 列表中的最小值。当前活跃事务中最早开始的。DB_TRX_ID < min_trx_id → 修改已提交 → 可见
系统下一个将分配的事务 ID(当前最大事务 ID + 1)。DB_TRX_ID ≥ max_trx_id → 修改来自"未来"事务 → 不可见
可见性判断的完整规则(从一行数据的 DB_TRX_ID 开始逐条判断):
| 判断条件 | 结论 | 说明 |
|---|---|---|
DB_TRX_ID == creator_trx_id | ✅ 可见 | 自己改的,自己当然能看到 |
DB_TRX_ID < min_trx_id | ✅ 可见 | 修改该行的事务在 ReadView 创建前已提交 |
DB_TRX_ID >= max_trx_id | ❌ 不可见 | 修改该行的事务在 ReadView 创建后才开始——“未来的修改” |
DB_TRX_ID 在 trx_ids 中 | ❌ 不可见 | 修改该行的事务在 ReadView 创建时还未提交 |
min_trx_id ≤ DB_TRX_ID < max_trx_id 且不在 trx_ids 中 | ✅ 可见 | 修改该行的事务在 ReadView 创建时已提交(不在活跃列表 = 已提交) |
把上面这张表画成决策流程,判断顺序一目了然——从版本链最新版本开始,逐条往下走:
flowchart TD
    A["读到一个版本的 DB_TRX_ID"] --> B{"DB_TRX_ID ==
creator_trx_id?"}
    B -->|"是"| VIS1["✅ 可见
自己改的"]
    B -->|"否"| C{"DB_TRX_ID
< min_trx_id?"}
    C -->|"是"| VIS2["✅ 可见
ReadView 创建前已提交"]
    C -->|"否"| D{"DB_TRX_ID
>= max_trx_id?"}
    D -->|"是"| INV1["❌ 不可见
'未来'事务的修改"]
    D -->|"否"| E{"DB_TRX_ID
在 trx_ids 中?"}
    E -->|"是"| INV2["❌ 不可见
ReadView 创建时未提交"]
    E -->|"否"| VIS3["✅ 可见
已提交(不在活跃列表)"]
    INV1 --> F["沿 DB_ROLL_PTR
找下一个旧版本"]
    INV2 --> F
    F --> A

    classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:2px,color:#ede9fe,font-weight:bold;
    classDef reject fill:#450a0a,stroke:#dc2626,stroke-width:2px,color:#fecaca,font-weight:bold;
    classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold;
    classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb;
    class A,F process;
    class B,C,D,E condition;
    class INV1,INV2 reject;
    class VIS1,VIS2,VIS3 data;
💡 判断口诀:先问"是不是自己"→ 再问"是不是够老(<min)"→ 再问"是不是太新(>=max)"→ 最后查"在不在活跃列表"。前两步直接放行,中间两步直接拒绝,最后一步查表定论。不可见就沿版本链往前找旧版本,直到找到可见的或走到链尾。
6. MVCC 完整流程:从 SELECT 到返回结果
这一节用一张完整的流程图串联前文所有知识点——SELECT 语句执行时,MVCC 从头到尾做了什么。

流程分四步:
第一步:创建 ReadView。RC 下每次 SELECT 都创建新的 ReadView(所以能看到别的事务刚提交的修改);RR 下只在事务第一次 SELECT 时创建(后续复用同一个 ReadView,保证一致性)。
第二步:B+树查找目标行。走聚簇索引或二级索引定位到聚簇索引叶子页中的最新行版本。
第三步:版本链遍历。读该行的 DB_TRX_ID,对照 ReadView 判断可见性。不可见?沿 DB_ROLL_PTR 跳到 Undo Log 中的上一个版本,继续判断,直到找到第一个可见版本或到达链表尾部。链表尾部就是 INSERT Undo——再往前就没有该行的任何版本了。
第四步:返回可见版本的数据。如果在版本链上找到了可见版本,返回那个版本对应的值。如果走到链尾还没找到可见版本(这种情况极少见——说明该行在 ReadView 创建之后才插入并且提交了),则该行对当前事务不可见,跳过这一行。
⚠️ 新手提示:REPEATABLE READ(RR)下的 MVCC 不是绝对意义上的"可重复读"——它只保证 已读过的行 不会变。如果事务 A 的 SELECT 还没扫到某个范围,事务 B 在该范围内插入新行并提交,事务 A 再次 SELECT 那个范围时能看到新行——这就是幻读。RR 的不彻底之处就在这里。彻底消除幻读要靠 Next-Key Lock(下篇讲)。
7. RC vs RR:ReadView 的创建时机决定了隔离级别
RC 和 RR 的隔离行为差异,根源在于 ReadView 创建的时机不同。

READ COMMITTED(RC):每次 SELECT 都创建新的 ReadView。这意味着每次读都能看到最新的已提交版本——不同事务的修改一旦提交就对当前事务可见。优点是"读已提交"语义简单、Undo Log 压力小(旧版本很快被 Purge 回收)。缺点是同一个事务内对同一行的两次查询可能得到不同结果(不可重复读)。
REPEATABLE READ(RR):只在本事务第一次 SELECT 时创建 ReadView,后续所有读复用同一个。ReadView 在事务开始时"冻结"了一幅快照,之后其他事务的任何提交在当前事务中都不可见。优点是避免了不可重复读。缺点是 Undo Log 压力大——一个长事务的 ReadView 持有很旧的 trx_ids 列表,阻止 Purge 线程回收任何它认为"不可见"的版本的 Undo Log。
| 维度 | RC(读已提交) | RR(可重复读) |
|---|---|---|
| ReadView 创建 | 每次 SELECT | 事务内首次 SELECT |
| 不可重复读 | 可能 | 不会 |
| Undo Log 压力 | 小 | 大(长事务致命) |
| 适用场景 | 报表统计、对一致性要求不高 | OLTP 业务(InnoDB 默认) |
MVCC 无法替代锁的场景:MVCC 只解决"读-写"冲突,而 写-写 冲突 MVCC 不管。假设当前行版本的 age=25,事务 A 和事务 B 同时读到 age=25 并都想改为 26。如果只用 MVCC,两个事务都会创建各自的新版本,最终只有一个能成功——另一个会在 COMMIT 时被检查到冲突(这个检查不是 MVCC 做的,是锁机制做的,下篇详述)。
8. 总结
MVCC 是理解 MySQL 事务的核心。三句话总结其本质:
MVCC 通过维护多版本数据实现了"读写互不阻塞"。每次修改产生新版本而非覆盖旧版本,读操作通过 ReadView 快照选择可见版本,完全不需要锁。
Undo Log + DB_ROLL_PTR 组成版本链。行记录的隐藏列指向 Undo Log 中的旧版本,形成一个由新到旧的单向链表。ReadView 沿链表遍历,找到第一个"当时已提交"的版本。
ReadView 的创建时机是 RC 和 RR 唯一的分叉。RC 每次 SELECT 创建新视图、RR 在事务首次 SELECT 创建后复用——这一差异决定了脏读和不可重复读的表现。
下一篇讲 MySQL 锁与日志系统——LBCC 的锁类型(Record Lock / Gap Lock / Next-Key Lock)、Redo Log 和 Binlog 的两阶段提交、以及崩溃恢复怎么靠日志保证数据不丢。