第4步:开发者 K8s 全景图 —— Ingress、Helm 和你的职责边界

开发者 K8s 全景图 一、目标说明 前四篇文章把 K8s 的概念地基、YAML 编写、探针配置、kubectl 命令全拆完了。这篇是收网篇——把剩下的重要但散落的知识点串起来,然后画一条清晰的线:什么归你管,什么扔给运维。 读完这篇文章,读者能: 写出完整的 Ingress YAML,理解域名路由规则 用 Helm 安装和管理应用( helm install / upgrade / rollback ) 选择适合自己场景的本地 K8s 环境 知道 StatefulSet、HPA、Job/CronJob、PVC 是干什么的、什么时候需要 认清 Dev vs Ops 的分界线,不再背不该背的锅 二、前置条件 前置条件 要求 理解 Service(ClusterIP/NodePort) 第 0 ~ 1 步已覆盖 会基本的 kubectl 操作 第 3 步已覆盖 了解域名和 HTTP 路径的基本概念 api.example.com/users 这种格式能看懂 三、分步实践 3.1 Ingress —— 域名路由,外部流量的大门 3.1.1 为什么需要 Ingress? Service 的三种类型: Service 类型 外部访问 问题 ClusterIP 不能 只能集群内用 NodePort 能( NodeIP:30000-32767 ) 端口丑、不能基于域名路由,一个端口只能绑一个 Service LoadBalancer 能(云 LB 分配公网 IP) 每个 Service 都要创建一个 LB,烧钱 Ingress 解决的问题:用一个入口(一个 LB / 一个公网 IP),根据域名和路径把流量分发到不同的 Service。 ...
一月 9, 2023 · 8 分钟 · 1621 字 · yaomingye

第3步:kubectl 生存手册 —— 开发者每天必敲的命令

kubectl 生存手册 一、目标说明 前三篇文章把概念、YAML、配置都讲完了。这一篇不讲"是什么",只讲 **“怎么查”**和 “怎么排” 。 这是整个系列最实用的一篇——开发者 90% 跟 K8s 打交道的时间,不是写 YAML,而是在这几个命令之间反复横跳: kubectl get → kubectl describe → kubectl logs → kubectl exec — 然后回到 get 读完这篇文章,读者能: 用 4 个核心查看命令快速定位问题 用 3 个交互命令深入容器内部或桥接流量 掌握 9 种 Pod 异常状态的完整诊断流程 用 -o wide/json/yaml 和 --sort-by 提取关键信息 建立"从现象到根因"的排查肌肉记忆 二、前置条件 前置条件 要求 本地 K8s 环境可用 kubectl cluster-info 正常 有几个 Pod 在跑 前几篇文章的 my-first-app 即可 理解 Pod / Deployment / Service 是什么 至少知道它们是干什么的 三、环境准备 沿用前面的 Namespace,确认有资源在跑: ...

一月 8, 2023 · 11 分钟 · 2166 字 · yaomingye

第2步:让 Pod 活得久一点 —— 探针、资源和配置注入实战

让 Pod 活得久一点 一、目标说明 上一篇文章成功部署了第一个 K8s 应用。但现实是——Pod 不会永远乖乖 Running。第二天打开监控一看:一个 Pod 被 OOMKilled,一个在 CrashLoopBackOff 无限重启,还有一个 Pending 了 3 小时没人管。 这篇文章要解决的就是:怎么让 Pod 活得久、死得明白、配置配得清楚。 读完这篇文章,读者能: 区分三种探针的适用场景,写出正确的探针配置 给容器设置合理的 resources 限制,避免 OOMKilled 和 CPU 被偷 掌握环境变量注入的 3 种方式及其选型标准 用 Volume Mount 把配置文件挂进 Pod 看懂 Pod 最常见的 6 种异常状态及其排查方向 二、前置条件 前置条件 要求 验证命令 已完成第 1 步 本地 K8s 能正常 deploy kubectl get deploy -n my-first-app 理解 Pod 基本概念 知道 Pod 里跑容器 看一眼第 0 步速查表即可 理解 Deployment 基本概念 知道 replicas、selector 看一眼第 1 步 Deployment YAML 即可 三、环境准备 沿用第 1 步的环境,先重新部署一遍做基准: ...

一月 7, 2023 · 8 分钟 · 1551 字 · yaomingye

第1步:写出你的第一个 K8s 应用

动手!部署你的第一个 K8s 应用 一、目标说明 上一篇文章把 Docker 和 K8s 的概念地图铺开了。这篇文章要做的是:真正动手,在本地 K8s 集群上部署一个完整的应用。 读完这篇文章,读者能: 验证本地 K8s 环境是否可用 写出一个完整的 Deployment YAML(并理解每一行在说什么) 写出 Service 让 Pod 可以稳定访问 用 ConfigMap 和 Secret 把配置从镜像里拆出来 用 kubectl apply 把整套东西一键部署 通过 kubectl port-forward 在浏览器里访问应用 二、前置条件 前置条件 要求 验证命令 Docker Desktop 已安装 4.x+ docker version Kubernetes 已开启 Docker Desktop Settings → Kubernetes → Enable Kubernetes kubectl cluster-info kubectl 已安装 Docker Desktop 自带 kubectl version --client 上一篇的概念理解 知道 Image / Container / Pod / Deployment / Service 是什么 脑子过一遍层级:Image → Container → Pod → Deployment 如果 kubectl cluster-info 输出类似以下内容,说明环境就绪: ...

一月 6, 2023 · 7 分钟 · 1422 字 · yaomingye

第0步:Docker 是什么,K8s 为什么要存在

Docker 与 K8s:从困惑到搞懂 一、目标说明 这篇文章要解决一个问题:一个从来没碰过容器的后端开发,怎么搞懂 Docker 和 K8s 那一堆名词? 读完这篇文章,读者能搞清楚以下事情: Docker 的 Image(镜像)和 Container(容器)到底是什么关系 为什么有了 Docker 还不够,还要搞一个 K8s 出来 K8s 的 Master / Worker Node 上各自跑了哪些组件,它们怎么配合 Pod、Deployment、Service、ConfigMap、Secret、Namespace 这些概念分别解决什么问题 一个 kubectl apply 命令背后,K8s 集群里发生了什么 ⚠️ 新手提示:这篇文章不会让你动手敲任何命令。目的是在脑子里建一张"K8s 全景地图"。有了这张地图,后面写 YAML、敲 kubectl 的时候才知道每一行是在操作什么东西。 二、前置条件 读者需要具备以下基础(都很基本): 前置知识 要求程度 验证方式 Linux 基本命令 会用 cd 、 ls 、 cat 、 ps 打开终端敲一下看看 进程概念 知道一个程序运行起来就是一个进程 打开任务管理器看一眼 IP + 端口 知道 127.0.0.1:8080 是什么意思 用过浏览器访问 localhost 即可 YAML 格式 见过 YAML,知道缩进表示层级 写过 Spring Boot 的 application.yml 就算 如果以上都 OK,往下看。 ...

一月 5, 2023 · 8 分钟 · 1581 字 · yaomingye

流控三板斧——Sentinel滑动窗口、令牌桶与Dubbo负载均衡

流控三板斧 前三篇讲了一个核心矛盾:分布式系统里——网络和时钟不可靠——所以你必须在一致性和可用性之间做取舍——Raft 用 majority 保证 CP——Nacos Distro 用最终一致性取 AP。 但取舍不只发生在数据一致性层面——流量控制层面同样存在。每个服务有自己的承载上限——超过上限就必须拒绝一部分请求——这就是限流。拒绝哪些请求?以什么粒度计数?桶还是窗口? 📌 前置知识:需要有 Sentinel 基本概念(知道它是限流熔断组件)和 Dubbo 基本用法(知道 @DubboReference 怎么调用远程服务)。如果还没用过 Sentinel 的 Dashboard——建议先对着官方文档跑一遍 Quick Start——不需要深入——但得知道控制台里"流控规则"长什么样。 一、为什么"每秒 100 个请求"这种限流方式有 Bug——固定窗口的边界突刺 对限流最直观的理解:系统处理能力是每秒 100 个——超过就拒绝。实现这个最简单的办法——搞一个计数器——每秒归零。 // 固定窗口计数器——最朴素的想法 class FixedWindowRateLimiter { private long windowStart = System.currentTimeMillis(); private int counter = 0; private final int limit = 100; public synchronized boolean tryAcquire() { long now = System.currentTimeMillis(); if (now - windowStart > 1000) { windowStart = now; // 新窗口——计数器归零 counter = 0; } if (counter < limit) { counter++; return true; // 放行 } return false; // 限流 } } 看起来没毛病——每秒最多通过 100 个——超过就拒绝。问题出在窗口边界: ...

一月 4, 2023 · 4 分钟 · 701 字 · yaomingye

谁说了算——Raft选举、心跳与故障检测在Nacos/Dubbo中的应用

谁说了算 前两篇讲了一个道理:网络和时钟不可靠 → 必须做取舍 → CAP 把取舍定了性。那具体怎么做取舍呢? 如果集群里只有一台机器——不存在一致性问题——所有写操作都在同一块硬盘上——谁先谁后清清楚楚。但只有一台机器的代价是——这台机器宕机——系统全挂。所以需要多台机器——而多台机器就需要一个机制来决定“谁的版本算数”。 这个机制在分布式系统里有一个正式的名字——共识算法(Consensus Algorithm)。Raft 是目前工程界最广泛使用的共识算法——不是因为它理论上最完美——而是因为它可以让人看得懂。 📌 前置知识:建议先读上篇 CAP 定理——理解 CP vs AP 的区别。Raft 是典型的 CP 实现——本文的 Raft 部分主要解释它如何实现 C(一致性)。 一、为什么要有人"说了算"——分布式写操作的困境 先看一个最简单的集群:三台机器——每台都存一份数据——都可以接受写请求。 客户端写入 x=1 → 节点 A 收到——更新本地 x=1 客户端写入 x=2 → 节点 B 收到——更新本地 x=2 (几乎同时——两个客户端连到了两个不同的节点) A 认为 x=1——B 认为 x=2——到底 x 是多少? 两者各自都认为自己的数据正确——没有人有权限说"听我的"——这就是分布式系统里最核心的问题——没有单点权威——写操作需要协调。 flowchart TD start["两个客户端——两个写请求——\n到达两个不同节点"]:::startEnd start --> c1["客户端 1 → 节点 A\nSET x=1"]:::data start --> c2["客户端 2 → 节点 B\nSET x=2"]:::data c1 --> conflict["节点 A:x=1\n节点 B:x=2\n⚡ 冲突——x 到底等于几?"]:::highlight c2 --> conflict conflict --> naive["最简单的方案:\n规定只有一台机器能接受写——\n这台机器叫 Leader"]:::data naive --> next_q["新问题:Leader 宕机了呢?\n谁当新 Leader?\n怎么告诉大家?"]:::condition classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef data fill:#052e16,stroke:#16a34a,stroke-width:1.5px,color:#bbf7d0,font-weight:bold; classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:1.5px,color:#ede9fe,font-weight:bold; Raft 要解决的就是这两个问题合在一起:(1) 选出一个大家都认可的 Leader——(2) Leader 挂了以后——自动选出新 Leader。 ...

一月 3, 2023 · 4 分钟 · 844 字 · yaomingye

CAP定理与一致性模型——从Nacos AP/CP双模理解取舍

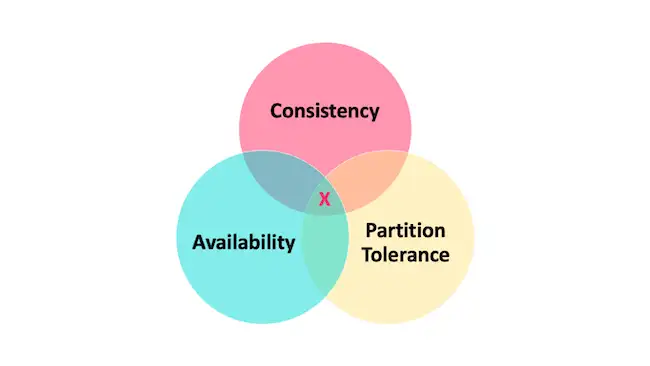
CAP 定理与一致性模型 上篇讲了两件事:网络不可靠、时钟不可信。结尾留了一句话——这两个不确定性叠加——迫使你在"等精确答案"和"快速给大致答案"之间选边站。 这句话有一个更正式的名字:CAP 定理。 但 CAP 被误解的程度——大概仅次于"TCP 三次握手"——绝大多数文章都把它简化成"一致性、可用性、分区容错性三者选其二"——就像点菜时三选二。 真正的 CAP 远比这复杂——而且它不是一个开关——而是一条光谱。 📌 前置知识:建议先读上篇——理解网络分区和时钟漂移的成因。另外需要有 Nacos 的基本使用经验(知道它可以做注册中心和配置中心即可)。 一、CAP 的经典定义——先搞清楚每个字母到底在说什么 CAP 是 Eric Brewer 在 2000 年提出的——后来由 Gilbert 和 Lynch 在 2002 年给出了形式化证明。注意——CAP 里的"证明"不是实验验证——是数学上严格证明了这三个性质不可能同时满足。 先搞清楚每个字母的精确含义: 字母 全称 经典定义 一句话翻译 C Consistency 每次读操作——都能读到最近一次写操作的结果——所有节点在同一时刻看到的数据完全一致 “你刚写的——马上就能读到” A Availability 每个发给非故障节点的请求——都能在有限时间内得到一个非错误的响应 “请求一定有人接——不会晾着你” P Partition Tolerance 系统在部分节点之间的网络被切断后——仍然能继续对外提供服务 “网线拔了——系统还能撑——不至于完全挂掉” ⚠️ 新手提示:CAP 里的 P(分区容错)不是"系统可以容忍多少台机器宕机"——那叫容错。P 的精确含义是——任意数量的消息丢失或延迟——系统不能进入不可恢复的状态。换句话说——P 不是在问"系统会不会出分区"——分区是客观物理现象——P 是在问"分区发生时——系统还能不能运转"。 现在用一张图看清楚:没有分区时的理想状态 vs 分区发生时的两难。 flowchart TD subgraph nopartition["无网络分区——理想状态"] direction TB c1["客户端写 x=1"]:::startEnd --> n1["节点 A\nx=1"]:::data c1 -.-> n2["节点 B\nx=1\n从 A 同步"]:::data r1["客户端读 x"]:::startEnd --> n2 n2 --> res1["返回 x=1 ✅\nC 和 A 都满足"]:::data end subgraph partition["网络分区发生——A 和 B 互相不可达"] direction TB c2["客户端写 x=2"]:::startEnd --> p1["节点 A\nx=2"]:::data p1 -.->|"❌ 分区——无法同步"| p2["节点 B\nx=1(旧值)"]:::data r2["客户端读 x"]:::startEnd --> p2 p2 --> choice{"节点 B 怎么回复?"}:::condition choice -->|"返回 x=1\n(旧值——保留可用性)"| ap["选了 A——牺牲 C\n❌ 一致性被破坏"]:::reject choice -->|"拒绝响应——\n等网络恢复"| cp["选了 C——牺牲 A\n❌ 可用性被破坏"]:::reject end classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef data fill:#052e16,stroke:#16a34a,stroke-width:1.5px,color:#bbf7d0,font-weight:bold; classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:1.5px,color:#ede9fe,font-weight:bold; classDef reject fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; 分区发生时——你只能在"接受不一致"和"拒绝服务"之间二选一。 ...

一月 2, 2023 · 4 分钟 · 759 字 · yaomingye

如果网络会骗你,时钟也会骗你——分布式世界的两个不确定性

如果网络会骗你,时钟也会骗你 单机程序写了几年,什么 bug 都见过——NullPointerException、死循环、线程不安全——但至少有一个信念是牢不可破的:调用一个方法,它要么返回结果,要么抛异常,不会凭空消失。 // 单机世界——确定性 boolean ok = service.deductStock(productId, 5); if (ok) { orderMapper.insert(order); // 扣成功了才下单 } 这段代码在单机上运行了成千上万次——从来没出过问题。if/else 的逻辑像物理定律一样可靠。 然后某天系统拆成了微服务。扣库存从本地方法调用变成了远程 RPC 调用: // 分布式世界——不确定性 boolean ok = rpcService.deductStock(productId, 5); // 这一行代码可能: // - 正常返回 true // - 正常返回 false // - 抛异常 // - 永远不返回——线程一直卡着 // - 扣库存成功——但响应包在网络丢了——你以为失败了 if (ok) { orderMapper.insert(order); } 从那一刻起——之前所有关于"确定性"的直觉——全部失效。 📌 前置知识:本文不需要任何分布式系统经验,但建议有基本的 TCP/HTTP 通信认知(知道"请求-响应"模式即可)。如果写过 Spring Boot 项目,理解 RPC 调用的概念,阅读体验会更好。 一、单机世界 vs 分布式世界——一张图看懂差异 单机程序中——所有事情都发生在一个进程里。方法调用是在同一块内存里跳转指令,操作系统保证要么执行完成、要么异常退出——不存在"不确定有没有执行"这种状态。 ...

一月 1, 2023 · 4 分钟 · 694 字 · yaomingye

MySQL 实战优化:从 EXPLAIN 到 NULL 陷阱

从 EXPLAIN 到 NULL 陷阱——优化其实有章可循 📌 前置知识:这篇是系列最后一篇,面向日常开发的实战视角。前四篇的理论基础——B+树、索引结构、MVCC、锁机制——这篇会直接引用而不重复展开。建议至少读过第一篇 B+树索引体系再看这篇。 1. EXPLAIN:优化器的自白 EXPLAIN 是 SQL 优化的第一工具。它不会替你优化 SQL,但它告诉你 MySQL 打算怎么优化你的 SQL——用了哪个索引、扫描多少行、做了什么额外操作。理解了它的输出,慢查询的根因通常一目了然。 EXPLAIN SELECT * FROM users WHERE name = 'Zhang' AND age > 20 ORDER BY id; 输出如下(省略部分列): +----+------+---------------+------+---------+-------+------+-------------------+ | id | type | possible_keys | key | key_len | ref | rows | Extra | +----+------+---------------+------+---------+-------+------+-------------------+ | 1 | ref | idx_name | idx | 102 | const | 120 | Using index cond | +----+------+---------------+------+---------+-------+------+-------------------+ 逐字段解读: ...

十二月 31, 2022 · 6 分钟 · 1208 字 · yaomingye
Cat Radio