MySQL 锁与日志系统:从并发控制到崩溃恢复

锁与日志:并发控制如何实现崩溃恢复 📌 前置知识:前三篇分别讲了 B+树索引、Join 原理、MVCC。这篇讲两个主题——锁(LBCC,基于锁的并发控制)和日志(Redo Log + Binlog)——它们分别在"正确性"和"持久性"上补足了 MVCC 的短板。MVCC 解决读-写冲突,锁解决写-写冲突;日志保证写入的数据断电不丢。 1. 锁的类型:InnoDB 到底有哪些锁 MVCC 让读者不需要锁就能看到一致的数据版本。但当两个事务同时修改同一行时,多版本帮不上忙——因为最终只能有一个版本成为"当前版本"。这就需要锁来协调写-写冲突。 InnoDB 的锁按粒度分为两级:表级锁和行级锁。 表级锁 锁类型 SQL 关键字 行为 表共享锁(S) LOCK TABLE t READ 自己可读不可写,其他人可读不可写 表排他锁(X) LOCK TABLE t WRITE 自己可读写,其他人连读都不行 意向共享锁(IS) 自动加 “我打算对其中某行加 S 锁”——在行上加 S 锁前必须先在表上加 IS 意向排他锁(IX) 自动加 “我打算对其中某行加 X 锁”——在行上加 X 锁前必须先在表上加 IX AUTO-INC 锁 自增列插入 插入自增主键时确保值连续递增 意向锁是 InnoDB 实现多粒度锁的关键。加行锁之前先加表级意向锁,这样其他事务要加表锁时只需检查表的意向锁就能知道该表是否有行锁,不需要逐行检查。比如事务 A 对某行加了 X 锁(先在表级加 IX 锁),事务 B 想 LOCK TABLE t WRITE(加表级 X 锁),B 一检查发现表上有 IX 锁,直接等待,不需要扫描所有的行。 ...

十二月 30, 2022 · 4 分钟 · 663 字 · yaomingye

事务消息 + 本地消息表 + 生产踩坑

事务消息 + 本地消息表 📖 前置阅读:本文是分布式事务系列的第四篇——假设你已经理解了 CAP/BASE 理论、Seata AT 的 undo_log 机制、TCC 的 Try/Confirm/Cancel 三阶段和 Saga 的补偿链。如果这些概念还陌生——先读 分布式事务本质——CAP、BASE 与四大方案、Seata AT 模式——undo_log 与二阶段原理 和 TCC + Saga——补偿型分布式事务。 一、⚡ 同步方案的瓶颈——为什么还需要异步方案 先回顾前面三篇文章我们做了什么: Seata AT:下单 → 扣库存 → 扣余额——三个操作在一个 @GlobalTransactional 中——同步执行 TCC:Try 预留 → Confirm 确认 → Cancel 回滚——三个阶段——同步执行 Saga:正向执行 → 失败逆补偿——协调者串联——同步执行 它们有一个共同特征:调用方要等所有分支都执行完——才返回结果。 order-service 调用 product-service 扣库存: → 发起 RPC 调用 → 等待 product-service 处理 → 等待 product-service 返回结果 → 拿到结果——继续下一步 如果 product-service 很慢——比如库存要查 3 个 Redis + 2 个 DB: → order-service 的线程就等着 → 线程池撑爆 → 整个链路超时 同步方案的根本矛盾:事务参与方的响应时间——直接影响调用方的吞吐量。 ...

十二月 30, 2022 · 17 分钟 · 3414 字 · yaomingye

MySQL 事务与 MVCC:多版本并发控制的完整原理

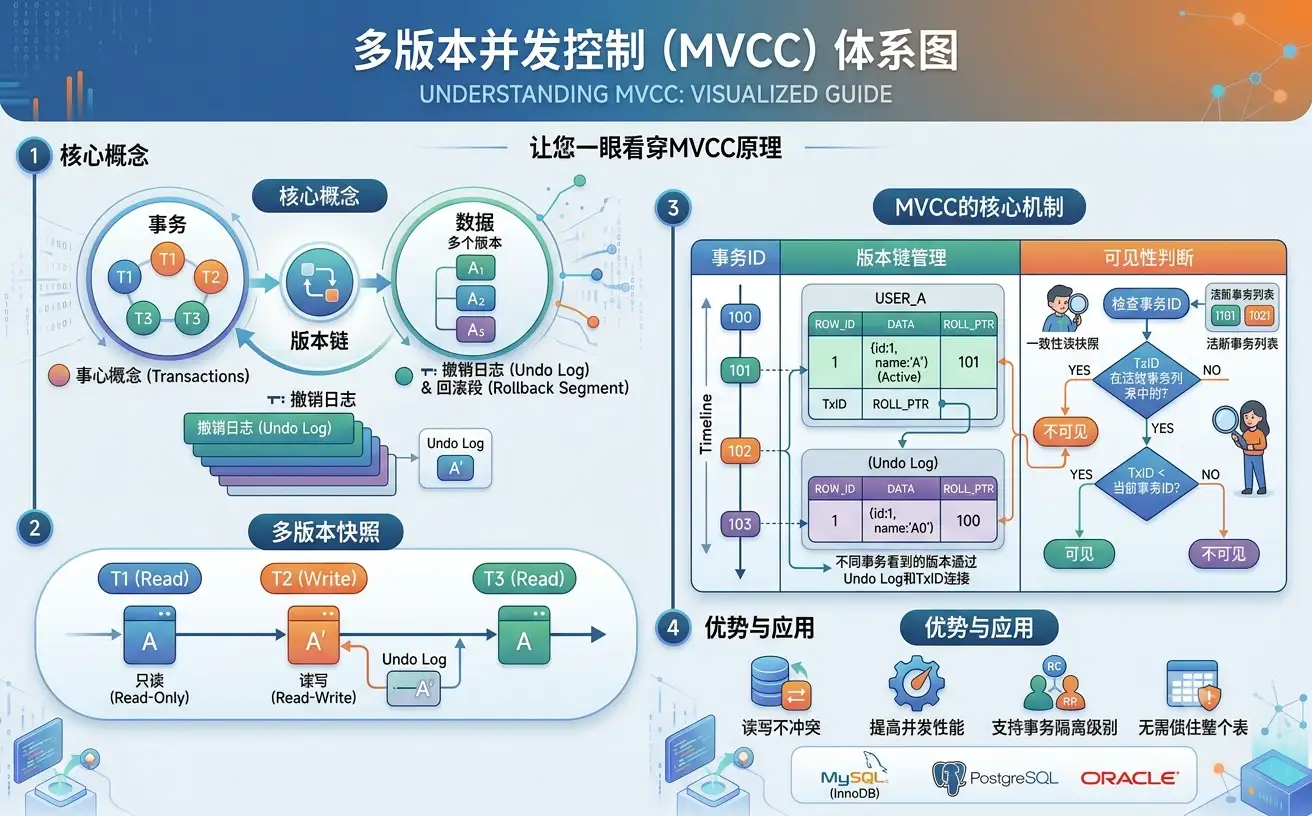
事务与 MVCC:多版本并发控制原理拆解 📌 前置知识:这篇需要理解前两篇的 B+树结构和聚簇索引。核心概念——隐藏列、Undo Log、ReadView——都是在 B+树的聚簇索引叶子页上工作的。建议读到这里时回想前文 InnoDB 页结构中 User Records 的记录头信息。 0. 60 秒速览:用一句话记住 MVCC 先别管术语,用一个生活场景建立直觉。 想象你正在写一份共享文档(Google Docs / 腾讯文档)。你打开它时,看到的是当时那个版本。别人在你之后改了几版,你不会突然看到"文档变了"——除非你刷新。你写的部分,别人在你保存前也看不到。 MySQL 的 MVCC 就是这个机制: 每次修改不覆盖原数据,而是生成一个新版本。读的人看到的是"自己开始读那一刻"的版本快照,写的人不影响正在读的人。 flowchart LR subgraph "同一行数据 (id=1, age=25)" V3["版本3 age=30DB_TRX_ID=300(当前行)"] V2["版本2 age=28DB_TRX_ID=200"] V1["版本1 age=25DB_TRX_ID=100(INSERT 原始版)"] end T1["事务A开始读"] -->|"ReadView 快照看到版本1"| V1 T2["事务B修改两次"] --> V2 T2 --> V3 V3 -.->|"DB_ROLL_PTR回滚指针"| V2 V2 -.->|"DB_ROLL_PTR"| V1 classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb; classDef root fill:#0f172a,stroke:#3b82f6,stroke-width:2.5px,color:#bfdbfe,font-weight:bold; class V1,V2,V3 data; class T1,T2 root; 这张图里有 MVCC 的全部核心零件,读完这篇你会逐个认识它们: ...

十二月 29, 2022 · 7 分钟 · 1350 字 · yaomingye

TCC + Saga——补偿型分布式事务

TCC + Saga 📖 前置阅读:本文假设读者已理解 Seata AT 模式的原理和局限。如果还不熟悉,建议先阅读 Seata AT 模式——undo_log 与二阶段原理。 一、⚡ AT 能回滚库存——但能回滚一条"已发出的短信"吗? AT 模式的局限——上一篇说了: AT 的自动回滚依赖 undo_log——生成反向 SQL INSERT → DELETE(undo_log 记录自增 ID——反向就是 DELETE) UPDATE → UPDATE(undo_log 记录前置镜像——反向就是把值改回去) 但以下操作——数据库回滚不了: ① 发了优惠券——HTTP POST 到营销系统的 API——数据库回滚不了 HTTP 调用 ② 发了短信——调了阿里云短信 API——阿里云不会因为你的"反向 SQL"就收回短信 ③ 调了第三方支付——Payment API 已经扣了钱——不能"生成反向 HTTP"退钱 ④ 给 Redis 写了一个计数器——Redis 没有 undo_log——AT 管不了 TCC 和 Saga 就是为这而生的——手动补偿——操作本身和撤回操作都由你写代码实现。 二、🔄 TCC——Try / Confirm / Cancel——你自己管理回滚 2.1 TCC 的本质——每个操作配一个"撤销操作" TCC 把每个业务操作拆成三个方法: Try(尝试) —— 预留资源——但不真正执行 Confirm(确认) —— 真正执行——Try 预留的资源生效 Cancel(取消) —— 释放 Try 预留的资源——回滚 和 AT 的区别: AT:你写一套代码——Seata 自动生成"撤销操作"(反向 SQL) TCC:你写三套代码——Try(正向)、Confirm(确认)、Cancel(撤销) → 写了三套代码——能处理任何类型的操作——不再局限于数据库 2.2 示例——“创建订单 + 发优惠券 + 扣积分”——用 TCC // ===== 场景:下单时——创建订单 + 发优惠券 + 扣积分 ===== // 订单是 DB 操作——但发优惠券是 HTTP API——扣积分也是 HTTP API // AT 回滚不了 HTTP API——用 TCC // ===== 订单服务——TCC 接口 ===== public interface OrderTccAction { /** * Try:预创建订单——状态为 PENDING——库存还没扣——订单还不能支付 * @param businessContext 在 TM 端传入的参数——和 @BusinessActionContextParameter 对应 */ @TwoPhaseBusinessAction( name = "order-create", // TCC 资源名 commitMethod = "confirmCreateOrder", // Confirm 方法 rollbackMethod = "cancelCreateOrder" // Cancel 方法 ) boolean tryCreateOrder( @BusinessActionContextParameter(paramName = "userId") Long userId, @BusinessActionContextParameter(paramName = "items") List<OrderItemDto> items, @BusinessActionContextParameter(paramName = "totalAmount") BigDecimal totalAmount ); /** * Confirm:把订单从 PENDING 变为 CREATED——正式生效 */ boolean confirmCreateOrder(BusinessActionContext context); /** * Cancel:把 PENDING 的订单变为 CANCELLED——释放预占 */ boolean cancelCreateOrder(BusinessActionContext context); } // ===== 订单服务——TCC 实现 ===== @Service public class OrderTccActionImpl implements OrderTccAction { @Autowired private OrderMapper orderMapper; @Override @Transactional public boolean tryCreateOrder(Long userId, List<OrderItemDto> items, BigDecimal totalAmount) { // ① 预创建订单——状态为 PENDING——不是正式订单 Order order = new Order(); order.setOrderNo(generateOrderNo()); order.setUserId(userId); order.setTotalAmount(totalAmount); order.setStatus(OrderStatus.PENDING); // ← PENDING——不是正式订单——不可支付 order.setCreatedAt(LocalDateTime.now()); orderMapper.insert(order); // ② 把 orderId 存入 BusinessActionContext——Confirm/Cancel 会用到 // Seata 自动把方法返回值之外的参数存入 Context // 这里通过 RootContext 手动放 RootContext.bind("orderId_" + RootContext.getXID(), order.getId()); return true; // Try 成功——等待 TC 通知 Confirm 或 Cancel } @Override @Transactional public boolean confirmCreateOrder(BusinessActionContext context) { // ① 从 Context 中取出 orderId Long orderId = (Long) context.getActionContext() .get("orderId_" + context.getXid()); // ② 把订单状态从 PENDING → CREATED——正式生效 Order order = orderMapper.selectById(orderId); if (order == null || order.getStatus() != OrderStatus.PENDING) { // 幂等——如果已经 Confirm 过了——不再处理 return true; } order.setStatus(OrderStatus.CREATED); orderMapper.updateById(order); return true; } @Override @Transactional public boolean cancelCreateOrder(BusinessActionContext context) { Long orderId = (Long) context.getActionContext() .get("orderId_" + context.getXid()); Order order = orderMapper.selectById(orderId); if (order == null) { // 空回滚——Try 还没执行——Cancel 先到了——不做处理 return true; } if (order.getStatus() == OrderStatus.CANCELLED) { // 幂等——已经取消过了 return true; } order.setStatus(OrderStatus.CANCELLED); orderMapper.updateById(order); return true; } } // ===== 优惠券服务——TCC 接口(HTTP API——AT 回滚不了)===== public interface CouponTccAction { @TwoPhaseBusinessAction( name = "coupon-grant", commitMethod = "confirmGrantCoupon", rollbackMethod = "cancelGrantCoupon" ) boolean tryGrantCoupon( @BusinessActionContextParameter(paramName = "userId") Long userId, @BusinessActionContextParameter(paramName = "couponType") String couponType ); boolean confirmGrantCoupon(BusinessActionContext context); boolean cancelGrantCoupon(BusinessActionContext context); } @Service public class CouponTccActionImpl implements CouponTccAction { @Autowired private CouponService couponService; // 这个 Service 调外部营销 API @Override public boolean tryGrantCoupon(Long userId, String couponType) { // Try:预占优惠券——调营销 API——标记为用户——但未激活 Coupon coupon = couponService.reserveCoupon(userId, couponType); // 外部 API 返回了 couponId RootContext.bind("couponId_" + RootContext.getXID(), coupon.getId()); return true; } @Override public boolean confirmGrantCoupon(BusinessActionContext context) { // Confirm:激活优惠券——用户可用 Long couponId = (Long) context.getActionContext() .get("couponId_" + context.getXid()); couponService.activateCoupon(couponId); // HTTP PUT /coupons/{id}/activate return true; } @Override public boolean cancelGrantCoupon(BusinessActionContext context) { // Cancel:回收优惠券——把预留的优惠券放回库存 Long couponId = (Long) context.getActionContext() .get("couponId_" + context.getXid()); if (couponId == null) { return true; // 空回滚——Try 还没执行完 } couponService.recycleCoupon(couponId); // HTTP DELETE /coupons/{id} return true; } } // ===== TM——全局事务发起方——调各个 TCC 接口 ===== @Service public class OrderApplicationService { @Autowired private OrderTccAction orderTccAction; @Autowired private CouponTccAction couponTccAction; @Autowired private PointTccAction pointTccAction; @GlobalTransactional public Order createOrderWithCoupon(CreateOrderRequest request) { // ① Try:预创建订单 boolean orderTry = orderTccAction.tryCreateOrder( request.getUserId(), request.getItems(), request.getTotalAmount()); if (!orderTry) throw new BusinessException("预创建订单失败"); // ② Try:预发优惠券——不是数据库操作——是 HTTP 调外部 API boolean couponTry = couponTccAction.tryGrantCoupon( request.getUserId(), "FIRST_ORDER"); if (!couponTry) throw new BusinessException("预发优惠券失败"); // ③ Try:预扣积分——也是 HTTP 调外部 API boolean pointTry = pointTccAction.tryDeductPoints( request.getUserId(), 100); if (!pointTry) throw new BusinessException("预扣积分失败"); // ④ 所有 Try 成功——TM 通知 TC 进 Confirm // TC 依次调每个 RM 的 confirmXxx() // → orderTccAction.confirmCreateOrder() ——订单 PENDING→CREATED // → couponTccAction.confirmGrantCoupon() ——优惠券激活 // → pointTccAction.confirmDeductPoints() ——积分确认扣除 return ...; // 返回订单信息 } // 如果任何一个 Try 抛异常——TC 依次调每个 RM 的 cancelXxx() // → orderTccAction.cancelCreateOrder() ——订单 PENDING→CANCELLED // → couponTccAction.cancelGrantCoupon() ——优惠券回收 // → pointTccAction.cancelDeductPoints() ——积分退回 } 2.3 TCC 的两个致命陷阱——空回滚与悬挂 陷阱一:空回滚——Try 没执行——Cancel 先到了 时间线: ① TM 调 Order TCC 的 Try——网络超时——TM 不知道 Try 成功了没有 ② TM 决定回滚——发起 Cancel ③ Cancel 到达 order-service——但此时 Try 还没收到(网络延迟)——或者 Try 正在执行 ④ Cancel 执行时——订单不存在(Try 还没创建)——Cancel 失败 这叫"空回滚"——Cancel 先于 Try 到达 解决——控制记录表: 在 Cancel 中——如果查不到订单——不能报错——记录一条"Cancel 已执行"的空记录 当 Try 终于到达时——先查"Cancel 是否已执行"——如果是——Try 不再执行 陷阱二:悬挂——Try 超时后——Cancel 执行了——Try 又到了 时间线: ① TM 调 Try——Try 执行中——卡住了(GC 停顿——网络延迟) ② TM 等 10 秒超时——发起 Cancel ③ Cancel 到达——顺利执行——订单状态改为 CANCELLED ④ 第 30 秒——Try 终于执行完了——订单 INSERT 进去了——状态是 PENDING ⑤ 结果:Cancel 已经执行了——但 Try 把数据又写进去了——这个 Try"悬挂"了 这叫"悬挂"——Try 在 Cancel 之后到达——Cancel 的撤销效果被 Try 覆盖了 解决——同样用控制记录表: Cancel 执行时——记录一条"xid=xxx 已 Cancel" Try 执行前——先查"xid=xxx 是否已 Cancel"——如果是——拒绝执行 -- ===== TCC 防悬挂 + 空回滚控制表——每个参与 TCC 的服务都建一张 ===== CREATE TABLE tcc_operation_record ( id BIGINT AUTO_INCREMENT PRIMARY KEY, xid VARCHAR(128) NOT NULL COMMENT '全局事务 ID', branch_id BIGINT NOT NULL COMMENT '分支事务 ID', action_name VARCHAR(64) NOT NULL COMMENT 'TCC 资源名——order-create/coupon-grant', status TINYINT NOT NULL COMMENT '1-Try 2-Confirm 3-Cancel', created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP, UNIQUE KEY uk_xid_branch_action (xid, branch_id, action_name) ) ENGINE=InnoDB DEFAULT CHARSET=utf8; // ===== 改进后的 TCC 实现——带防悬挂 + 空回滚 ===== @Service public class OrderTccActionImpl implements OrderTccAction { @Autowired private TccOperationRecordMapper recordMapper; @Override @Transactional public boolean tryCreateOrder(Long userId, List<OrderItemDto> items, BigDecimal totalAmount) { String xid = RootContext.getXID(); Long branchId = RootContext.getBranchId(); // ① 防悬挂——检查 Cancel 是否已执行 TccOperationRecord cancelRecord = recordMapper.selectOne( xid, branchId, "order-create", 3); // status=3 = Cancel if (cancelRecord != null) { // Cancel 先到了——Try 不能再执行——这就是"悬挂"——拒绝 return false; } // ② 记录 Try TccOperationRecord tryRecord = new TccOperationRecord(); tryRecord.setXid(xid); tryRecord.setBranchId(branchId); tryRecord.setActionName("order-create"); tryRecord.setStatus(1); // Try recordMapper.insert(tryRecord); // ③ 执行业务逻辑 Order order = new Order(); // ... 创建订单——状态 PENDING orderMapper.insert(order); RootContext.bind("orderId_" + xid, order.getId()); return true; } @Override @Transactional public boolean cancelCreateOrder(BusinessActionContext context) { String xid = context.getXid(); Long branchId = context.getBranchId(); // ① 幂等——检查 Cancel 是否已执行 TccOperationRecord existingRecord = recordMapper.selectOne( xid, branchId, "order-create", 3); if (existingRecord != null) { return true; // Cancel 已经执行过了——幂等——直接返回 } // ② 记录 Cancel——在查订单之前——防止空回滚 TccOperationRecord cancelRecord = new TccOperationRecord(); cancelRecord.setXid(xid); cancelRecord.setBranchId(branchId); cancelRecord.setActionName("order-create"); cancelRecord.setStatus(3); // Cancel recordMapper.insert(cancelRecord); // ③ 空回滚处理——查不到订单——不能报错 Long orderId = (Long) context.getActionContext().get("orderId_" + xid); if (orderId == null) { return true; // Try 没执行——空回滚——正常 } Order order = orderMapper.selectById(orderId); if (order == null) { return true; // Try 没执行完——空回滚——正常 } if (order.getStatus() == OrderStatus.CANCELLED) { return true; // 幂等 } // ④ 执行业务撤销 order.setStatus(OrderStatus.CANCELLED); orderMapper.updateById(order); return true; } } ⚠️ 新手提示:空回滚和悬挂是 TCC 的两个经典坑——90% 的 TCC 实现都有这两个问题。解决方案就是一张操作记录表——在 Cancel 执行前先记一笔"Cancel 已执行"——在 Try 执行前先查"Cancel 是否已执行"。记录表的唯一键 (xid, branch_id, action_name) 天然防并发——并发的 Try 和 Cancel 只有一个能插入成功。 ...
十二月 29, 2022 · 8 分钟 · 1671 字 · yaomingye

MySQL Join 原理:B+树上的表连接

B+树上的表连接——彻底搞懂 Join 📌 前置知识:这篇基于前一篇 B+树索引体系的内容。默认读者已经理解聚簇索引、二级索引、回表、B+树叶子链表这几个概念。这不会是一篇"查字典"式的 SQL 语法说明,而是从 InnoDB 引擎视角解释 Join 到底在干什么。 1. Join 的本质:笛卡尔积的引擎视角 从数学上讲,Join 是两张表的 笛卡尔积 + 过滤条件: SELECT * FROM A JOIN B ON A.id = B.a_id WHERE A.age > 20; 逻辑上等价于:先穷举 A × B 的所有组合(笛卡尔积),再保留满足 A.id = B.a_id AND A.age > 20 的行。但现实中没有引擎会真去算笛卡尔积——100 万 × 100 万 = 1 万亿行,物理世界做不到。 MySQL 实际的做法是:选一张表做驱动(外层循环),另一张做被驱动(内层查找),逐行匹配。算法的核心差异在于"如何查找被驱动表中匹配的行"——这才有了 SNLJ、BNLJ、INLJ、Hash Join 四种策略。 flowchart TD DRIVER["🔁 驱动表(外层)逐行读取"] --> CHECK{"被驱动表\n有可用索引?"} CHECK -->|"有"| INLJ["Index Nested-Loop\n每行走 B+树查找"] CHECK -->|"无"| BNLJ["Block Nested-Loop\nJoin Buffer 批量匹配"] BNLJ --> HASHCHECK{"MySQL 8.0+\n且等值连接?"} HASHCHECK -->|"是"| HJ["Hash Join\n构建哈希表替代 B+树"] HASHCHECK -->|"否"| BNLJ2["仍用 BNLJ 或 SNLJ"] classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:1.5px,color:#ede9fe,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; class DRIVER startEnd class CHECK,HASHCHECK condition class INLJ,BNLJ,HJ highlight class BNLJ2 process 这四种算法,接下来逐个拆解。 ...

十二月 28, 2022 · 4 分钟 · 699 字 · yaomingye

Seata AT 模式——undo_log 与二阶段原理

Seata AT 模式 📖 前置阅读:本文假设读者已理解分布式事务的核心问题(多数据库操作一致性)和 BASE 最终一致性概念。如果还不熟悉,建议先阅读 分布式事务本质——CAP、BASE 与四大方案。 一、⚡ Seata AT 一句话——你写你的 SQL——它自动生成反向 SQL 回想 XA 2PC 的问题——锁住数据库行等协调者——性能黑洞。Seata AT 是怎么解决的? XA 2PC 的做法(性能黑洞): ① Prepare:执行 SQL——不提交——锁住行 ② 等协调者——这期间这些行都是锁着的——其他事务不能动 ③ Commit/Rollback:提交或回滚——释放锁 Seata AT 的做法(攒反向 SQL——事后再补): ① 一阶段:执行 SQL——立即提交——释放锁——同时记录 undo_log(反向 SQL) ② 如果全局事务成功:删掉 undo_log——完事 ③ 如果全局事务失败:根据 undo_log 执行反向 SQL——把数据改回去 核心区别:XA 是锁住行等结果——Seata 是先把活干了——记下 undo_log——失败了逆向执行。 二、🏗️ Seata 架构——TC / TM / RM 三角 flowchart LR TM["TM(Transaction Manager)\n全局事务管理者\n-- 标注 @GlobalTransactional"] RM1["RM(Resource Manager)\norder-service\n-- 操作 order 数据库"] RM2["RM(Resource Manager)\nproduct-service\n-- 操作 product 数据库"] RM3["RM(Resource Manager)\naccount-service\n-- 操作 account 数据库"] TC["TC(Transaction Coordinator)\nSeata Server\n-- 协调全局事务——管理全局锁"] TM -->|"① 开启全局事务"| TC TM -->|"② 调用 order-service"| RM1 RM1 -->|"③ 一阶段:执行业务 SQL + 记录 undo_log + 向 TC 注册分支事务"| TC TM -->|"④ 调用 product-service"| RM2 RM2 -->|"⑤ 一阶段:执行业务 SQL + 记录 undo_log + 注册分支事务"| TC TM -->|"⑥ 调用 account-service"| RM3 RM3 -->|"⑦ 一阶段:执行业务 SQL + 记录 undo_log + 注册分支事务"| TC TM -->|"⑧ 全局事务成功 → 通知 TC 提交"| TC TC -->|"⑨ 二阶段:通知所有 RM 删除 undo_log"| RM1 TC -->|"⑨ 通知所有 RM 删除 undo_log"| RM2 TC -->|"⑨ 通知所有 RM 删除 undo_log"| RM3 classDef style_TM fill:#431407,stroke:#ea580c,stroke-width:2px,color:#fed7aa; classDef style_TC fill:#450a0a,stroke:#dc2626,stroke-width:2px,color:#fecaca; class TM style_TM; class TC style_TC;``` | 角色 | 全称 | 作用 | 在哪里 | |------|------|------|------| | TC | Transaction Coordinator | 协调全局事务——管理全局锁——决定提交还是回滚 | Seata Server——独立部署 | | TM | Transaction Manager | 定义全局事务边界——标 `@GlobalTransactional` 的方法 | 发起方服务(order-service) | | RM | Resource Manager | 管理分支事务——执行 undo_log 记录——向 TC 注册 | 每个参与方服务(product/account) | ## 三、🔍 undo_log 的核心原理——Seata AT 的灵魂 ### 3.1 undo_log 表结构 ```sql -- 每个参与分布式事务的数据库都需要一张 undo_log 表 -- Seata 提供了建表 SQL——直接执行即可 CREATE TABLE undo_log ( id BIGINT(20) NOT NULL AUTO_INCREMENT, branch_id BIGINT(20) NOT NULL COMMENT '分支事务 ID', xid VARCHAR(100) NOT NULL COMMENT '全局事务 ID', context VARCHAR(128) NOT NULL COMMENT '上下文', rollback_info LONGBLOB NOT NULL COMMENT '回滚信息——记录前置镜像和后置镜像', log_status INT(11) NOT NULL COMMENT '状态:0-正常 1-全局事务已完成', log_created DATETIME NOT NULL, log_modified DATETIME NOT NULL, PRIMARY KEY (id), UNIQUE KEY ux_undo_log (xid, branch_id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8; 3.2 undo_log 的工作原理——前置镜像 + 后置镜像 以"扣库存"为例——product 服务执行:UPDATE product SET stock = stock - 5 WHERE id = 1 一阶段——执行 SQL + 记录 undo_log: ① Seata 拦截 SQL——先查一下当前数据: SELECT stock FROM product WHERE id = 1 → stock = 10 ② 执行你的业务 SQL: UPDATE product SET stock = stock - 5 WHERE id = 1 → stock = 5 (后置镜像) ③ 立即提交——不锁行——释放数据库锁 ④ 记录 undo_log: 前置镜像:stock = 10 (SQL 执行前的值) 后置镜像:stock = 5 (SQL 执行后的值) 反向 SQL:UPDATE product SET stock = 10 WHERE id = 1 ⑤ 向 TC 注册:我的分支事务完成了——xid=xxx——undo_log 已记录 二阶段——提交: 全局事务成功 → TC 通知所有 RM 提交 → 删掉 undo_log 记录 → 完事 二阶段——回滚: 全局事务失败 → TC 通知所有 RM 回滚 → 读 undo_log 中的反向 SQL → 执行: UPDATE product SET stock = 10 WHERE id = 1 然后把数据改回去了 → 删掉 undo_log 记录 关键——为什么 AT 比 XA 快: ...

十二月 28, 2022 · 8 分钟 · 1567 字 · yaomingye

MySQL B+树索引体系

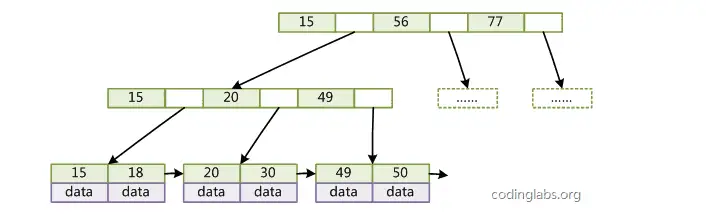
MySQL B+树索引体系:从数据结构到查询执行 📌 前置知识:读者需了解磁盘与内存的速度差异(磁盘寻道 ~ 10ms,内存访问 ~ 100ns),以及基本的数据结构概念(链表、树、二分查找)。本文所有讨论基于 InnoDB 存储引擎。 1. 为什么是 B+树 MySQL 的数据是存在磁盘上的。磁盘 IO 的速度比内存慢约 10 万倍,所以数据库设计的第一原则是:尽量减少磁盘 IO 次数。 要理解为什么用 B+树,先看二叉搜索树(BST,Binary Search Tree)。 在 BST 中,每个节点只存一个键,每层只有两个子节点。如果数据量是 100 万行,树高就是 log₂(1000000) ≈ 20 层。执行一次查找最多需要 20 次磁盘 IO——因为每一层的节点都可能分散在不同的磁盘页上,每次读一个节点就是一次磁盘 IO。 这个代价太高了。解决的思路是:让每个节点存更多的键,增加每层的分叉数,降低树的高度。 flowchart LR root1["🌳 二叉树 ⚡20层 IO 100万数据"] --> root2["🌲 多路查找树 ⚡3 ~ 4层 IO 100万数据"] root2 --> leaf["叶子链表 范围扫描"] classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef leaf fill:#052e16,stroke:#16a34a,stroke-width:1.5px,color:#bbf7d0,font-weight:bold; class root1,root2 startEnd class leaf leaf 从二叉树到 B+树的演进: ...

十二月 27, 2022 · 7 分钟 · 1315 字 · yaomingye

分布式事务本质——CAP、BASE 与四大方案

分布式事务本质 一、⚡ @Transactional 在生产中失效——不是代码写错了——是底层就不是一回事 先看一个场景——最经典的"下单扣库存": // 单体应用——一个 @Transactional 搞定 @Service public class OrderService { @Transactional public void createOrder(CreateOrderRequest request) { // ① 创建订单 orderMapper.insert(order); // ② 扣库存 product.setStock(product.getStock() - quantity); productMapper.updateById(product); // ③ 扣余额 account.setBalance(account.getBalance().subtract(totalAmount)); accountMapper.updateById(account); // 这三个操作在同一个数据库中——同一个事务——要么全成功——要么全回滚 } } 拆成微服务后——同样的流程——@Transactional 失效: order-service ──→ 创建订单(自己的数据库) product-service ──→ 扣库存(product 数据库) account-service ──→ 扣余额(account 数据库) 每个服务有独立的数据库——三个 @Transactional 是三个独立的事务 → 订单创建成功——库存扣减成功——但扣余额失败 → 订单已创建——库存已扣——余额没变——钱还在——但东西已经扣了 → 数据不一致——用户赚了——公司亏了 分布式事务的本质问题:多个数据库(或服务)的操作——怎么保证"要么全成功、要么全回滚"? ...

十二月 27, 2022 · 4 分钟 · 706 字 · yaomingye

GitLab CI/CD 多环境部署与生产实践

从 dev 一路跑到 prod——点个按钮就上线 📖 前置阅读:本文假设读者已搭建 GitLab CI/CD 流水线(编译 → 测试 → 扫描 → 构建镜像 → 推送 Harbor),并已将微服务部署在 Kubernetes 上。如果还不熟悉,建议先阅读 搭建与 Pipeline 语法精讲 和 流水线实战。 一、⚡ 镜像推到 Harbor 了——但你还得手动 SSH 上去 kubectl apply——这叫啥 CI/CD? 前两篇搭好了 CI/CD Pipeline——代码 push → 编译 → 测试 → 扫描 → 构建镜像 → 推送到 Harbor。 但 Pipeline 到这里就停了——后面的部署还是人来操作: 当前状态(半自动): ✅ 代码 push → 自动编译、测试、扫描、构建镜像、推送 Harbor ❌ 然后——SSH 到跳板机 → kubectl set image → 看有没有报错 ❌ 然后——curl 验证——发现不对——kubectl rollout undo ❌ 然后——staging 和 prod 没有隔离——改了什么全凭记忆力 → CI 有了——CD 没做——半吊子自动化 真正的 CD——镜像推送到 Harbor 后——自动部署到 dev——验证通过——自动部署到 staging——人工审批——部署到 prod。人对生产的操作只剩下"点一个按钮"。 ...

十二月 26, 2022 · 9 分钟 · 1903 字 · yaomingye

GitLab CI/CD 流水线实战——编译、扫描、构建镜像、推送仓库

代码 push 之后——五道关卡自动跑完 📖 前置阅读:本文假设读者已搭建 GitLab + Runner 并理解 .gitlab-ci.yml 基础语法(stages/jobs/artifacts/cache/rules)。如果还不熟悉,建议先阅读 GitLab CI/CD 搭建与 Pipeline 语法精讲。 一、⚡ 编译过了——但你敢直接部署吗?代码质量谁保证? 上一篇文章的 Pipeline 只做了编译和测试——但真正的 CI/CD 不止这些: 真正的 CI/CD 流水线要回答 5 个问题: ① 编译成功了吗? → mvn compile ② 测试通过了吗? → mvn test + 覆盖率报告 ③ 代码质量合格吗? → SonarQube 扫描 + Quality Gate ④ 镜像构建成功了吗? → docker build ⑤ 镜像推送到仓库了吗? → docker push → Harbor 这 5 步全自动——缺一步都不能算 CI/CD 这篇的目标——搭一条完整的流水线:代码 push → 自动跑完上述 5 步——任何一个环节失败——Pipeline 变红——阻止部署。 二、🏗️ 完整的 Pipeline 架构 flowchart LR Push["git push"] --> Compile["① 编译\nmvn compile"] Compile --> Test["② 单元测试\nmvn test\n+ 覆盖率报告"] Test --> SonarQube["③ 代码扫描\nSonarQube\n+ Quality Gate"] SonarQube --> Package["④ 打包\nmvn package"] Package --> DockerBuild["⑤ 构建镜像\ndocker build"] DockerBuild --> HarborPush["⑥ 推送仓库\ndocker push\n→ Harbor"] HarborPush --> Notify["⑦ 通知\n企业微信/钉钉"] classDef style_SonarQube fill:#450a0a,stroke:#dc2626,stroke-width:2px,color:#fecaca; classDef style_HarborPush fill:#0f172a,stroke:#3b82f6,stroke-width:2px,color:#bfdbfe; class SonarQube style_SonarQube; class HarborPush style_HarborPush;``` ## 三、🔧 基础设施——SonarQube + Harbor 搭建 ### 3.1 Docker Compose——加 SonarQube 和 Harbor ```yaml # 在上一篇文章的 docker-compose.yml 基础上加两个服务 version: '3.8' services: # ===== GitLab + Runner(同上一篇——省略)===== # ... # ===== SonarQube——代码质量扫描 ===== sonarqube: image: sonarqube:10.3.0-community container_name: sonarqube environment: SONAR_JDBC_URL: jdbc:postgresql://sonarqube-db:5432/sonarqube SONAR_JDBC_USERNAME: sonar SONAR_JDBC_PASSWORD: sonar123 ports: - "9000:9000" volumes: - sonarqube-data:/opt/sonarqube/data - sonarqube-extensions:/opt/sonarqube/extensions depends_on: - sonarqube-db sonarqube-db: image: postgres:15-alpine container_name: sonarqube-db environment: POSTGRES_USER: sonar POSTGRES_PASSWORD: sonar123 POSTGRES_DB: sonarqube volumes: - sonarqube-db-data:/var/lib/postgresql/data # ===== Harbor——私有 Docker 镜像仓库 ===== # Harbor 官方推荐用 docker-compose 独立部署——这里简化 # 生产环境参考 https://goharbor.io/docs harbor: image: goharbor/registry-photon:v2.9.0 container_name: harbor-registry ports: - "5000:5000" volumes: - harbor-data:/var/lib/registry volumes: sonarqube-data: sonarqube-extensions: sonarqube-db-data: harbor-data: 3.2 SonarQube 初始化——创建项目 Token ① 浏览器打开 http://gitlab.local:9000 ② 默认登录:admin / admin——首次强制修改密码 ③ Administration → Projects → Create Project → Project key: order-service → Project name: order-service → 创建 ④ 创建 Token:My Account → Security → Generate Token → Token name: gitlab-ci → 复制 Token——后续要放在 GitLab CI/CD 变量中 ⑤ 在 GitLab 中配置 SonarQube 变量: GitLab → 项目 → Settings → CI/CD → Variables 添加: SONAR_HOST_URL = http://sonarqube:9000 SONAR_TOKEN = squ_xxxxxxxxxxxxxxxxxxxxxxxxxx ← 刚才复制的 Token 3.3 Maven 项目的 SonarQube 配置 <!-- pom.xml——加 JaCoCo 覆盖率插件 + SonarQube 插件 --> <build> <plugins> <!-- JaCoCo——代码覆盖率 --> <plugin> <groupId>org.jacoco</groupId> <artifactId>jacoco-maven-plugin</artifactId> <version>0.8.11</version> <executions> <execution> <goals> <goal>prepare-agent</goal> </goals> </execution> <execution> <id>report</id> <phase>test</phase> <goals> <goal>report</goal> </goals> </execution> </executions> </plugin> </plugins> </build> <properties> <!-- SonarQube 配置 --> <sonar.host.url>${env.SONAR_HOST_URL}</sonar.host.url> <sonar.login>${env.SONAR_TOKEN}</sonar.login> <sonar.projectKey>order-service</sonar.projectKey> <sonar.projectName>order-service</sonar.projectName> <sonar.java.binaries>target/classes</sonar.java.binaries> <sonar.coverage.jacoco.xmlReportPaths>target/site/jacoco/jacoco.xml</sonar.coverage.jacoco.xmlReportPaths> </properties> 四、📝 完整的 .gitlab-ci.yml——从编译到推送镜像 4.1 完整 Pipeline 定义 # order-service/.gitlab-ci.yml # 完整的 CI/CD Pipeline——5 个阶段 stages: - compile # ① 编译 - test # ② 测试 + 覆盖率 - quality # ③ SonarQube 扫描 - package # ④ 打包 + 构建镜像 - push # ⑤ 推送镜像到 Harbor # ===== 全局变量 ===== variables: MAVEN_OPTS: "-Dmaven.repo.local=$CI_PROJECT_DIR/.m2/repository" MAVEN_CLI_OPTS: "-B -Dorg.slf4j.simpleLogger.log.org.apache.maven.cli.transfer.Slf4jMavenTransferListener=WARN" # Harbor 地址——在 GitLab CI/CD Variables 中配置 HARBOR_URL: "harbor.local:5000" IMAGE_NAME: "$HARBOR_URL/order-service" # ===== 全局缓存——Maven 依赖 ===== cache: key: maven-${CI_COMMIT_REF_SLUG} paths: - .m2/repository/ policy: pull-push # ===== Stage 1: 编译 ===== compile: stage: compile image: maven:3.9-eclipse-temurin-17 script: - mvn $MAVEN_CLI_OPTS compile artifacts: paths: - target/classes/ expire_in: 1 hour tags: - docker # ===== Stage 2: 单元测试 + 覆盖率 ===== unit-test: stage: test image: maven:3.9-eclipse-temurin-17 script: - mvn $MAVEN_CLI_OPTS test jacoco:report artifacts: when: always paths: - target/surefire-reports/ - target/site/jacoco/ # ← JaCoCo 报告——给 SonarQube 用 expire_in: 7 days reports: junit: target/surefire-reports/TEST-*.xml # ← GitLab 自动展示测试结果 coverage: '/Total.*?([0-9]{1,3})%/' # ← GitLab 自动展示覆盖率百分比 tags: - docker # ===== Stage 3: SonarQube 代码扫描 ===== sonarqube-check: stage: quality image: maven:3.9-eclipse-temurin-17 script: - mvn $MAVEN_CLI_OPTS sonar:sonar -Dsonar.host.url=$SONAR_HOST_URL -Dsonar.login=$SONAR_TOKEN # 只在 MR 或 main 分支扫描——feature 分支不扫(浪费 SonarQube 资源) rules: - if: $CI_PIPELINE_SOURCE == "merge_request_event" - if: $CI_COMMIT_BRANCH == "main" tags: - docker # ===== Stage 4: 打包 ===== package: stage: package image: maven:3.9-eclipse-temurin-17 script: - mvn $MAVEN_CLI_OPTS package -DskipTests artifacts: paths: - target/*.jar expire_in: 1 hour tags: - docker # ===== Stage 5: 构建 Docker 镜像并推送到 Harbor ===== docker-build-push: stage: push image: docker:24-dind # ← Docker-in-Docker 镜像——在容器内跑 Docker services: - docker:24-dind # ← 启动 Docker daemon sidecar before_script: - apk add --no-cache bash # Alpine 需要 bash # 等待 Docker daemon 启动 - until docker info > /dev/null 2>&1; do sleep 1; done script: # ① 构建镜像——用 commit SHA 作为 tag - docker build -t $IMAGE_NAME:$CI_COMMIT_SHORT_SHA . # ② 打标签——如果 main 分支——打 latest;如果有 tag——打 release 版本 - | if [ "$CI_COMMIT_BRANCH" = "main" ]; then docker tag $IMAGE_NAME:$CI_COMMIT_SHORT_SHA $IMAGE_NAME:latest fi - | if [ -n "$CI_COMMIT_TAG" ]; then docker tag $IMAGE_NAME:$CI_COMMIT_SHORT_SHA $IMAGE_NAME:$CI_COMMIT_TAG fi # ③ 登录 Harbor——用户名密码配在 GitLab CI/CD Variables 中 - echo "$HARBOR_PASSWORD" | docker login $HARBOR_URL -u "$HARBOR_USERNAME" --password-stdin # ④ 推送所有标签 - docker push $IMAGE_NAME:$CI_COMMIT_SHORT_SHA - | if [ "$CI_COMMIT_BRANCH" = "main" ]; then docker push $IMAGE_NAME:latest fi - | if [ -n "$CI_COMMIT_TAG" ]; then docker push $IMAGE_NAME:$CI_COMMIT_TAG fi tags: - docker 4.2 Dockerfile——配合 CI/CD 的镜像构建 # order-service/Dockerfile # 多阶段构建——分离构建和运行——最终镜像只含 JRE # ===== Stage 1: 构建——用 Maven 编译 ===== FROM maven:3.9-eclipse-temurin-17 AS builder WORKDIR /build COPY pom.xml . # 先下载依赖——利用 Docker 缓存层——pom.xml 不变就不重新下载 RUN mvn dependency:go-offline -B COPY src ./src RUN mvn package -DskipTests -B # ===== Stage 2: 运行——只含 JRE——镜像小 ===== FROM eclipse-temurin:17-jre-alpine WORKDIR /app # 创建非 root 用户——安全最佳实践 RUN addgroup -S appgroup && adduser -S appuser -G appgroup # 从构建阶段复制 jar COPY --from=builder /build/target/*.jar app.jar # 切换到非 root 用户 USER appuser # Health check——K8s 会调用这个 HEALTHCHECK --interval=30s --timeout=5s --retries=3 \ CMD wget -qO- http://localhost:8081/actuator/health || exit 1 EXPOSE 8081 ENTRYPOINT ["java", "-jar", "app.jar"] ⚠️ 新手提示:上面的 Dockerfile 是"CI 内编译"的方式——jar 包在 CI Pipeline 中由 Maven 打好——Dockerfile 只需要 COPY jar。还有一种方式是"Dockerfile 内编译"——CI 不编译——Dockerfile 用多阶段构建完成编译。两种方式的区别: ...

十二月 25, 2022 · 8 分钟 · 1615 字 · yaomingye
Cat Radio