MySQL Join 原理:B+树上的表连接
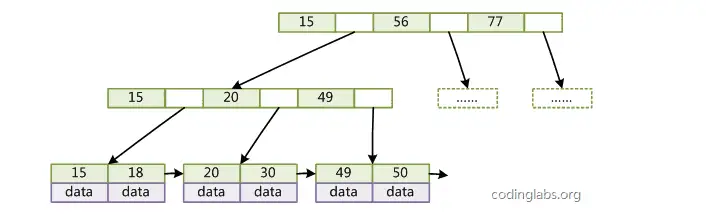
B+树上的表连接——彻底搞懂 Join 📌 前置知识:这篇基于前一篇 B+树索引体系的内容。默认读者已经理解聚簇索引、二级索引、回表、B+树叶子链表这几个概念。这不会是一篇"查字典"式的 SQL 语法说明,而是从 InnoDB 引擎视角解释 Join 到底在干什么。 1. Join 的本质:笛卡尔积的引擎视角 从数学上讲,Join 是两张表的 笛卡尔积 + 过滤条件: SELECT * FROM A JOIN B ON A.id = B.a_id WHERE A.age > 20; 逻辑上等价于:先穷举 A × B 的所有组合(笛卡尔积),再保留满足 A.id = B.a_id AND A.age > 20 的行。但现实中没有引擎会真去算笛卡尔积——100 万 × 100 万 = 1 万亿行,物理世界做不到。 MySQL 实际的做法是:选一张表做驱动(外层循环),另一张做被驱动(内层查找),逐行匹配。算法的核心差异在于"如何查找被驱动表中匹配的行"——这才有了 SNLJ、BNLJ、INLJ、Hash Join 四种策略。 flowchart TD DRIVER["🔁 驱动表(外层)逐行读取"] --> CHECK{"被驱动表\n有可用索引?"} CHECK -->|"有"| INLJ["Index Nested-Loop\n每行走 B+树查找"] CHECK -->|"无"| BNLJ["Block Nested-Loop\nJoin Buffer 批量匹配"] BNLJ --> HASHCHECK{"MySQL 8.0+\n且等值连接?"} HASHCHECK -->|"是"| HJ["Hash Join\n构建哈希表替代 B+树"] HASHCHECK -->|"否"| BNLJ2["仍用 BNLJ 或 SNLJ"] classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:1.5px,color:#ede9fe,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; class DRIVER startEnd class CHECK,HASHCHECK condition class INLJ,BNLJ,HJ highlight class BNLJ2 process 这四种算法,接下来逐个拆解。 ...