Linux IO 模型

Linux IO 模型:阻塞、非阻塞、多路复用与异步 IO 全解析 1 ⚡ 问题切入:一个后端开发者必须回答的问题 假设你在面试中被问到: “一台 4 核 8GB 的服务器,为什么能支撑 10 万个并发连接?” 答案的关键不在于 CPU 有多快、内存有多大,而在于 IO 模型 。如果每个连接用一个线程、每个线程做阻塞 IO,10 万连接就需要 10 万个线程——每个线程消耗约 1MB 栈空间,仅线程栈就占 100GB 内存,4 核 CPU 也根本无法调度这么多线程。 真正让高并发成为可能的,是 非阻塞 IO 和 IO 多路复用 (I/O Multiplexing,单个线程同时监听多个 IO 事件)。Nginx、Redis、Netty 的高性能都建立在正确的 IO 模型选择之上。 这篇博客从操作系统层面讲解 Linux 五大 IO 模型,聚焦于"数据如何从网卡/磁盘到达你的程序",为后续理解 Java NIO、Netty、Kafka 等框架打下理论基础。 2 💻 硬件架构:一次 IO 操作经历了什么 在讨论 IO 模型之前,必须先理解一次 IO 操作涉及哪些硬件组件以及数据如何流转。 如上图所示,一次典型的网络 IO 读取,数据经过以下路径: ...

九月 13, 2022 · 9 分钟 · 1736 字 · yaomingye

Java IO 缓冲流与装饰器模式

Java IO 缓冲流与装饰器模式:从性能对比到设计模式全解析 1 ⚡ 问题切入:为什么单字节读取一个 10MB 文件要 30 秒? 先看一段能跑的代码。下面这段程序用 FileInputStream 的 read() 方法,一个字节一个字节地读取一个 10MB 的文件,并写入到另一个文件: // 无缓冲:单字节读取 try (FileInputStream fis = new FileInputStream("source_10mb.bin"); FileOutputStream fos = new FileOutputStream("dest_10mb.bin")) { int b; while ((b = fis.read()) != -1) { // 每次只读 1 字节 fos.write(b); // 每次只写 1 字节 } } 在我的机器上(Windows 11,SSD),这段代码的运行耗时约为 28,000 ms (28 秒)。 现在再看另一段代码,功能完全一样,只是在外层各包了一个缓冲流: // 有缓冲:仍然单字节读取 try (BufferedInputStream bis = new BufferedInputStream( new FileInputStream("source_10mb.bin")); BufferedOutputStream bos = new BufferedOutputStream( new FileOutputStream("dest_10mb.bin"))) { int b; while ((b = bis.read()) != -1) { // 仍然每次只读 1 字节 bos.write(b); // 仍然每次只写 1 字节 } } 耗时:约 150 ms 。两者相差约 180 倍 。代码逻辑完全一样(都是循环内单字节读写),一行包的差别,性能天差地别。 ...

九月 9, 2022 · 10 分钟 · 1942 字 · yaomingye

CAS 从硬件到 Java:MESI 视角下的原子操作与 12 个原子类

CAS 从硬件到 Java 🤔 一、Intel 的工程师为什么要给 CPU 加一条 lock cmpxchg 指令 多线程编程中最基础的问题——count++ 不是原子操作。Java 层面它是三条字节码,CPU 层面它是 “LOAD → ADD → STORE” 三条指令。两个核心同时执行,结果必然互相覆盖。 一种解决思路是加锁——synchronized 把整个 count++ 包住,一次只有一个线程执行。但锁的代价高:上下文切换、线程阻塞/唤醒、内核态切换。高竞争场景下,线程在等待锁上花的时间可能比干活的时间还多。 有没有办法不阻塞线程、靠硬件指令实现原子更新?Intel 的 CPU 架构师提供了一个答案:lock cmpxchg(Compare and Swap)指令。它将"比较旧值→如果匹配就写新值"这个过程变成一条不可分割的 CPU 指令,配合 lock 前缀锁定总线(或缓存行),保证同一时刻只有一个核心能成功操作该内存地址。 这个思路的妙处在于:把"锁"从软件层(JVM / OS Mutex)下沉到硬件层(CPU 缓存一致性协议)。失败重试的代价只是几个 CPU 周期,不死锁、不阻塞、不切换上下文。道格·李在 JUC 中大量依赖 CAS 来构建无锁数据结构——ConcurrentHashMap 的 bucket 写入、ConcurrentLinkedQueue 的节点插入、AQS 的 state 更新,底层全是 CAS。 本文从 CAS 的硬件原理开始,一直讲到 Java 的 12 个原子类。 🏗️ 二、MESI 视角:为什么硬件需要 CAS 🏗️ 2.1 两个 CPU 同时写一个变量——MESI 的"竞速" 从 MESI 协议的角度重新审视 i++ 的三条指令。假设两个 CPU 核心(Core A 和 Core B)同时尝试对同一地址执行 ++: ...

八月 21, 2022 · 9 分钟 · 1876 字 · yaomingye

volatile 如何填补 MESI 的两个缺口:Store Buffer 与 Invalidate Queue

volatile 如何填补 MESI 的缺口? 🤔 一、JSR 133 专家组为什么需要重新定义 volatile 在 JDK 1.4 及以前,Java 的 volatile 语义是模糊的。规范只说"对 volatile 变量的读写会直接在主内存进行",但什么叫"直接在主内存"、写入后多久另一个线程能看到、volatile 变量之间的指令能不能重排——这些问题都没有答案。不同 JVM 实现的行为不一致:有的插了内存屏障,有的什么都没做。 这直接导致了著名的双重检查锁定(DCL)单例在 Java 中不可靠的问题——即使 instance 声明为 volatile,在早期的 JMM 下仍然可能读到未初始化完成的对象。这个问题在当时被广泛讨论,甚至让不少开发者对 Java 并发编程失去了信心。 2004 年,JSR 133 专家组(道格·李是核心成员)重新定义了 volatile 的语义。新的 volatile 不再是一个模糊的"直接读写主内存",而是精确指定了四种内存屏障(LoadLoad、StoreStore、LoadStore、StoreLoad)在 volatile 读写前后的插入位置。 这个重新定义的本质是:用软件契约填补硬件盲区。Store Buffer 延迟写可见性 → volatile 写之后插 StoreLoad 屏障强制刷新。Invalidate Queue 延迟失效 → volatile 读之后插 LoadLoad 屏障强制缓存失效。指令重排序可能把 volatile 写后的普通写提到前面 → volatile 写之前插 StoreStore 屏障禁止。 volatile 不是用来做"原子操作"的(那是 CAS 的活),它的唯一职责是:保证一个线程对 volatile 变量的写入,对后续读取该 volatile 变量的其他线程立即可见。这就是 JSR 133 专家组对它的最终定义。 ...

八月 19, 2022 · 9 分钟 · 1724 字 · yaomingye

JMM 如何借鉴 MESI:Java 内存模型的概念引入

JMM 如何借鉴 MESI? 🏗️ 一、JSR 133 专家组为什么需要定义 JMM 上一篇文章讲完了 MESI 协议。它让所有核心看到一致的数据,但有一个前提:只管理 L1 Cache 之间的总线通信。Store Buffer、Invalidate Queue、编译器和 CPU 的指令重排序——这三样东西 MESI 完全不管。 CPU 架构师不管是有意为之:关掉 Store Buffer 和 Invalidate Queue 的代价是几十倍的性能损失,没有哪个芯片厂会做这种亏本买卖。但 Java 程序员不能不管——如果写了一个 stopped = true,另一个线程永远看不到,这就是线上事故。 2004 年,JSR 133 专家组(道格·李是核心成员之一)面临的问题很明确:不同的 CPU 架构有不同的内存模型(x86 是 TSO,ARM/PowerPC 更弱),Java 不能为每种 CPU 写一套并发程序。 Java 的"一次编写,到处运行"在并发领域受到了硬件差异的致命挑战。 专家组的选择是:在 Java 语言规范中定义一套软件层的内存可见性契约——JMM(Java Memory Model)。JMM 不规定 JVM 怎么实现(不管你是插 lock 指令还是 dmb 屏障),只管规则:如果你写了 volatile,那么 volatile 写之前的操作对 volatile 读之后的操作可见。 JMM 的核心参考模型就是 MESI。它将 MESI 的硬件概念映射为语言层的抽象: 🧠 二、JMM 的定位:一层"软件级缓存一致性" JMM 不是一个运行时可执行的东西。它是一套写在 Java 语言规范中的规则。它不规定 JVM 必须怎么实现 volatile——它只规定:如果你写了 volatile,那么 volatile 写之前的操作对 volatile 读之后的操作可见。 ...

八月 18, 2022 · 5 分钟 · 988 字 · yaomingye

MESI 缓存一致性协议

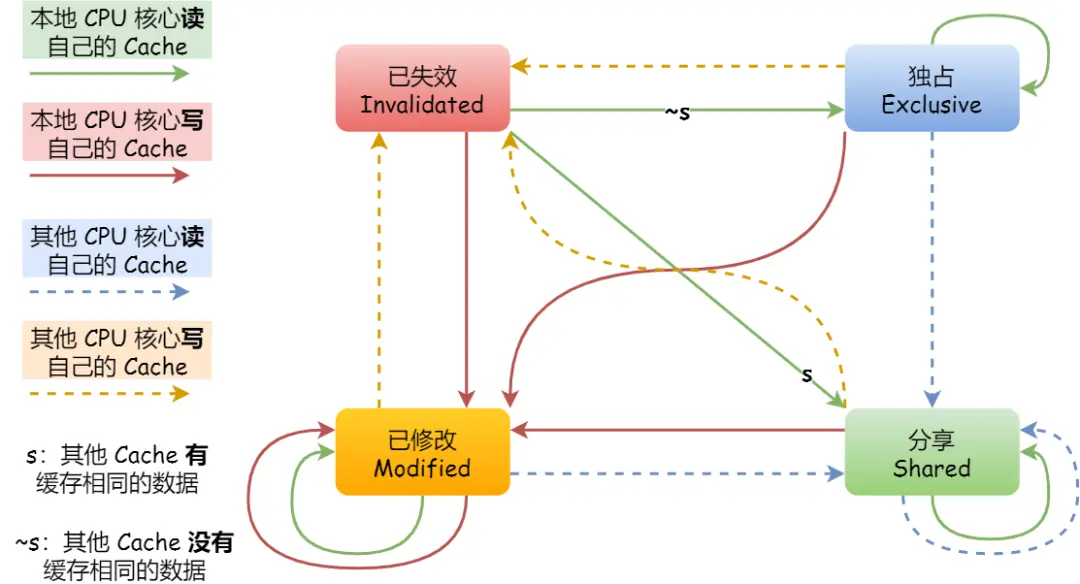
MESI 协议:CPU 是怎么保证缓存一致的? 🤔 一、CPU 架构师为什么需要 MESI 协议 1970 年代,CPU 直接从内存读数据,内存足够快。到了 1990 年代,CPU 主频飙到几百 MHz,内存还是几十 ns 的访问延迟——一颗 200MHz 的 CPU,等一次内存读取等于浪费十几个指令周期。CPU 架构师的应对方案是加缓存:把热数据放在离核心最近的地方。 缓存解决了速度问题,但制造了一个新问题:多核 CPU 中,同一个内存地址可能在多个核心的私有缓存中各有副本。 Core A 修改了 count = 1,Core B 的缓存中 count 还是 0——Core B 基于过期数据继续算,结果全错。 这个问题的本质不是"哪个值更正确",而是各个核心对同一地址的数据要有统一的认知——这就是缓存一致性(Cache Coherence)。没有它,多核处理器就等于多个单核处理器各算各的,合不起来。 Intel 架构师给出的答案就是 MESI 协议。它在每个缓存行上维护一个 2 位状态机——M(Modified,已修改且独占)、E(Exclusive,独占且干净)、S(Shared,多副本共享)、I(Invalid,本副本无效)。核心之间通过总线监听彼此的读写操作,自动在四种状态之间切换。 MESI 保证两件事:对同一地址的写操作最终对所有核心可见;所有核心对同一地址的写操作有一个全局一致的顺序(serialization)。它不是"所有核心时刻看到完全相同的值"——电信号传递本身有延迟,那是不可能的。它保证的是:给定足够时间,一致性一定会达成。 🏗️ 二、CPU 缓存层级结构 💾 2.1 三级缓存布局 现代多核 CPU 的缓存分为三级。L1/L2 每个核心私有,L3 所有核心共享: flowchart TD %% 半暗底色 + 高亮描边:完美适配博客深色/浅色双主题 %% classDef highlight fill:#431407,stroke:#ea580c,stroke-width:2px,color:#fed7aa,font-weight:bold; classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb; subgraph Core0["CPU Core 0"] L1_0[L1 Cache\n32KB 指令 + 32KB 数据] L2_0[L2 Cache\n256KB ~ 1MB] end subgraph Core1["CPU Core 1"] L1_1[L1 Cache\n32KB 指令 + 32KB 数据] L2_1[L2 Cache\n256KB ~ 1MB] end L1_0 --> L2_0 L1_1 --> L2_1 L2_0 --> L3[L3 Cache / LLC\n所有核心共享\n数MB ~ 数十MB] L2_1 --> L3 L3 --> MEM[主内存RAM] class L1_0,L1_1,L2_0,L2_1,L3 data; class Core0,Core1 highlight; class MEM process; 关键点: ...
八月 18, 2022 · 15 分钟 · 3144 字 · yaomingye
Cat Radio