AQS 源码重走:从 Doug Lea 的 CLH 变体到 JDK 21 的完整路径

AQS 源码重走:从「如果让我写」到「原来还可以这样」 某开发者背了一周 AQS 八股:CLH 队列、acquireQueued、shouldParkAfterFailedAcquire……面试官问「AQS 的 prev 和 next 为什么一个可靠一个不可靠?」——答了,但说不出这么设计是为了解决什么问题。面试官一句话戳穿:「你读过源码,但你有没有想过在并发场景下删队列中的一个节点,不这么写会发生什么?」 背源码最大的问题是:你不知道那些代码是在解决什么问题。 所以这篇文章不走寻常路——先问「如果不用 AQS,让我自己写一个锁排队框架,该怎么下手?」然后一步步推演,当你发现「哎这里不安全怎么办」的时候,再引出 Doug Lea 的解法。这个过程会让人惊叹:原来并发代码还可以这样写。 最后,会专门对比 JDK 8 和 JDK 21 两个版本的 AQS,讲清楚 Doug Lea 为什么在 JDK 21 中对核心逻辑做了一次大重构。 🏗️ 从零开始:如果让我实现一个可排队的锁 假设只有 synchronized 和 LockSupport.park/unpark ,让你实现一个「锁没抢到就排队等」的框架,你打算怎么写? 第一次尝试:一个粗暴的实现 // 初版思路 class NaiveLock { volatile int state = 0; // 0=未锁, 1=已锁 Queue<Thread> queue = new ... // 等待队列 void lock() { while (!CAS(&state, 0, 1)) { // 没抢到锁 queue.enqueue(currentThread()); // 入队 park(); // 阻塞 } } void unlock() { state = 0; // 释放锁 Thread t = queue.dequeue(); // 从队列取一个 unpark(t); // 唤醒 } } 看上去好像没问题。但仔细想想,全是坑: ...
十月 21, 2023 · 20 分钟 · 4200 字 · yaomingye

HashMap 源码十八拷:从 put/get 到红黑树,八股文背后的 JDK 设计逻辑

打开 HashMap.java,从第 1 行读到第 2587 行 某开发者背了三天八股,面试官问「HashMap 怎么定位桶的」——「计算 hashCode,扰动,然后 (n-1) & hash 」。面试官点头又问:「那为什么要扰动,直接 (n-1) & hashCode 不行吗?」——卡住了。 其实 HashMap.java 的开头注释里写得很明白:Because the table uses power-of-two masking, sets of hashes that vary only in bits above the current mask will always collide. 因为用的是 2 的幂掩码,高位不同的 key 会撞。这才是设计动机,不是「某大牛说 XOR 一下好」。 本文换个路子,打开 JDK 21 的 java.util.HashMap (2587 行),从上到下、按源码书写顺序走一遍。每遇到一个常量、一个方法、一个分支,不只说它是什么,说它为什么是它。 第一站:类声明和那篇著名的注释 // HashMap.java:139 public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable { 类签名平平无奇,真正的宝藏从第 145 行开始——一段大几百字的 Implementation notes。这大概是 Java 标准库里含金量最高的注释之一,建议每个读源码的人在这停个十分钟。 ...

十月 19, 2023 · 16 分钟 · 3203 字 · yaomingye

MySQL 锁与日志系统:从并发控制到崩溃恢复

锁与日志:并发控制如何实现崩溃恢复 📌 前置知识:前三篇分别讲了 B+树索引、Join 原理、MVCC。这篇讲两个主题——锁(LBCC,基于锁的并发控制)和日志(Redo Log + Binlog)——它们分别在"正确性"和"持久性"上补足了 MVCC 的短板。MVCC 解决读-写冲突,锁解决写-写冲突;日志保证写入的数据断电不丢。 1. 锁的类型:InnoDB 到底有哪些锁 MVCC 让读者不需要锁就能看到一致的数据版本。但当两个事务同时修改同一行时,多版本帮不上忙——因为最终只能有一个版本成为"当前版本"。这就需要锁来协调写-写冲突。 InnoDB 的锁按粒度分为两级:表级锁和行级锁。 表级锁 锁类型 SQL 关键字 行为 表共享锁(S) LOCK TABLE t READ 自己可读不可写,其他人可读不可写 表排他锁(X) LOCK TABLE t WRITE 自己可读写,其他人连读都不行 意向共享锁(IS) 自动加 “我打算对其中某行加 S 锁”——在行上加 S 锁前必须先在表上加 IS 意向排他锁(IX) 自动加 “我打算对其中某行加 X 锁”——在行上加 X 锁前必须先在表上加 IX AUTO-INC 锁 自增列插入 插入自增主键时确保值连续递增 意向锁是 InnoDB 实现多粒度锁的关键。加行锁之前先加表级意向锁,这样其他事务要加表锁时只需检查表的意向锁就能知道该表是否有行锁,不需要逐行检查。比如事务 A 对某行加了 X 锁(先在表级加 IX 锁),事务 B 想 LOCK TABLE t WRITE(加表级 X 锁),B 一检查发现表上有 IX 锁,直接等待,不需要扫描所有的行。 ...

十二月 30, 2022 · 4 分钟 · 663 字 · yaomingye

MySQL 事务与 MVCC:多版本并发控制的完整原理

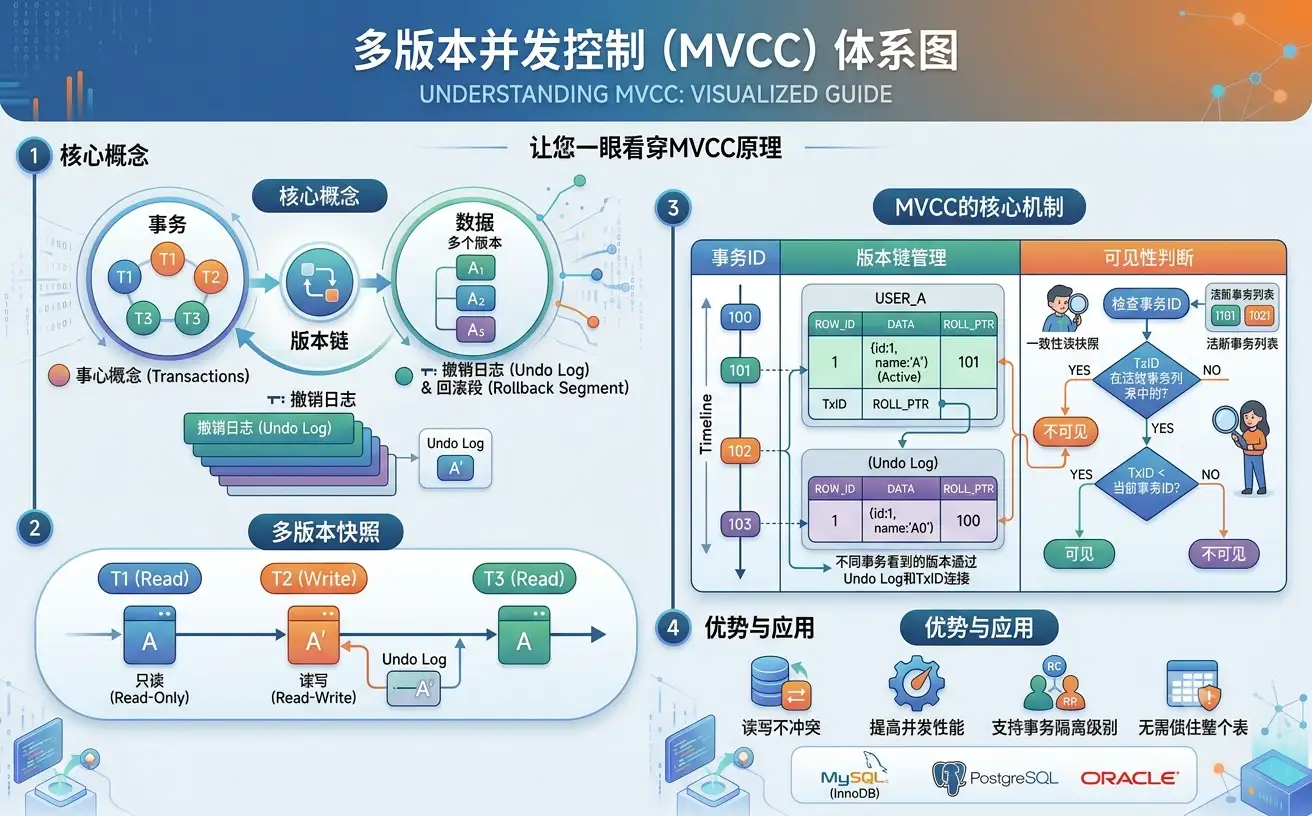
事务与 MVCC:多版本并发控制原理拆解 📌 前置知识:这篇需要理解前两篇的 B+树结构和聚簇索引。核心概念——隐藏列、Undo Log、ReadView——都是在 B+树的聚簇索引叶子页上工作的。建议读到这里时回想前文 InnoDB 页结构中 User Records 的记录头信息。 0. 60 秒速览:用一句话记住 MVCC 先别管术语,用一个生活场景建立直觉。 想象你正在写一份共享文档(Google Docs / 腾讯文档)。你打开它时,看到的是当时那个版本。别人在你之后改了几版,你不会突然看到"文档变了"——除非你刷新。你写的部分,别人在你保存前也看不到。 MySQL 的 MVCC 就是这个机制: 每次修改不覆盖原数据,而是生成一个新版本。读的人看到的是"自己开始读那一刻"的版本快照,写的人不影响正在读的人。 flowchart LR subgraph "同一行数据 (id=1, age=25)" V3["版本3 age=30DB_TRX_ID=300(当前行)"] V2["版本2 age=28DB_TRX_ID=200"] V1["版本1 age=25DB_TRX_ID=100(INSERT 原始版)"] end T1["事务A开始读"] -->|"ReadView 快照看到版本1"| V1 T2["事务B修改两次"] --> V2 T2 --> V3 V3 -.->|"DB_ROLL_PTR回滚指针"| V2 V2 -.->|"DB_ROLL_PTR"| V1 classDef data fill:#052e16,stroke:#16a34a,stroke-width:2px,color:#bbf7d0,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:2px,color:#e5e7eb; classDef root fill:#0f172a,stroke:#3b82f6,stroke-width:2.5px,color:#bfdbfe,font-weight:bold; class V1,V2,V3 data; class T1,T2 root; 这张图里有 MVCC 的全部核心零件,读完这篇你会逐个认识它们: ...

十二月 29, 2022 · 7 分钟 · 1350 字 · yaomingye

MySQL Join 原理:B+树上的表连接

B+树上的表连接——彻底搞懂 Join 📌 前置知识:这篇基于前一篇 B+树索引体系的内容。默认读者已经理解聚簇索引、二级索引、回表、B+树叶子链表这几个概念。这不会是一篇"查字典"式的 SQL 语法说明,而是从 InnoDB 引擎视角解释 Join 到底在干什么。 1. Join 的本质:笛卡尔积的引擎视角 从数学上讲,Join 是两张表的 笛卡尔积 + 过滤条件: SELECT * FROM A JOIN B ON A.id = B.a_id WHERE A.age > 20; 逻辑上等价于:先穷举 A × B 的所有组合(笛卡尔积),再保留满足 A.id = B.a_id AND A.age > 20 的行。但现实中没有引擎会真去算笛卡尔积——100 万 × 100 万 = 1 万亿行,物理世界做不到。 MySQL 实际的做法是:选一张表做驱动(外层循环),另一张做被驱动(内层查找),逐行匹配。算法的核心差异在于"如何查找被驱动表中匹配的行"——这才有了 SNLJ、BNLJ、INLJ、Hash Join 四种策略。 flowchart TD DRIVER["🔁 驱动表(外层)逐行读取"] --> CHECK{"被驱动表\n有可用索引?"} CHECK -->|"有"| INLJ["Index Nested-Loop\n每行走 B+树查找"] CHECK -->|"无"| BNLJ["Block Nested-Loop\nJoin Buffer 批量匹配"] BNLJ --> HASHCHECK{"MySQL 8.0+\n且等值连接?"} HASHCHECK -->|"是"| HJ["Hash Join\n构建哈希表替代 B+树"] HASHCHECK -->|"否"| BNLJ2["仍用 BNLJ 或 SNLJ"] classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:1.5px,color:#ede9fe,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; class DRIVER startEnd class CHECK,HASHCHECK condition class INLJ,BNLJ,HJ highlight class BNLJ2 process 这四种算法,接下来逐个拆解。 ...

十二月 28, 2022 · 4 分钟 · 699 字 · yaomingye

MySQL B+树索引体系

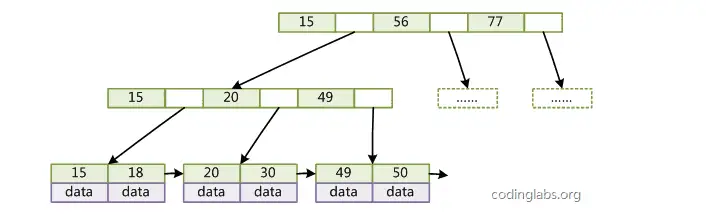
MySQL B+树索引体系:从数据结构到查询执行 📌 前置知识:读者需了解磁盘与内存的速度差异(磁盘寻道 ~ 10ms,内存访问 ~ 100ns),以及基本的数据结构概念(链表、树、二分查找)。本文所有讨论基于 InnoDB 存储引擎。 1. 为什么是 B+树 MySQL 的数据是存在磁盘上的。磁盘 IO 的速度比内存慢约 10 万倍,所以数据库设计的第一原则是:尽量减少磁盘 IO 次数。 要理解为什么用 B+树,先看二叉搜索树(BST,Binary Search Tree)。 在 BST 中,每个节点只存一个键,每层只有两个子节点。如果数据量是 100 万行,树高就是 log₂(1000000) ≈ 20 层。执行一次查找最多需要 20 次磁盘 IO——因为每一层的节点都可能分散在不同的磁盘页上,每次读一个节点就是一次磁盘 IO。 这个代价太高了。解决的思路是:让每个节点存更多的键,增加每层的分叉数,降低树的高度。 flowchart LR root1["🌳 二叉树 ⚡20层 IO 100万数据"] --> root2["🌲 多路查找树 ⚡3 ~ 4层 IO 100万数据"] root2 --> leaf["叶子链表 范围扫描"] classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef leaf fill:#052e16,stroke:#16a34a,stroke-width:1.5px,color:#bbf7d0,font-weight:bold; class root1,root2 startEnd class leaf leaf 从二叉树到 B+树的演进: ...

十二月 27, 2022 · 7 分钟 · 1315 字 · yaomingye

Kafka Consumer 深入:位移管理与 Rebalance

Kafka Consumer 深入 📖 前置阅读:本文假设读者已掌握 SpringBoot Kafka 的基本消费操作(@KafkaListener)。如果还不熟悉,建议先阅读 SpringBoot Kafka 全操作指南。 一、⚡ 问题切入:消费者重启后,怎么知道上次读到哪了? RabbitMQ 的答案是"消息消费后就删了,不需要记位置"。RocketMQ 的答案是"Broker 帮你记 offset"。Kafka 的答案是——消费者自己记,记在一个叫 __consumer_offsets 的内部 Topic 里: 消费者在 Partition-2 上消费到 offset=1500 ↓ 提交 offset __consumer_offsets Topic: Key: (order-consumer-group, order-topic, 2) Value: offset=1500 消费者重启 ↓ ↓ 读取 offset 从 offset=1501 继续消费 这个设计是 Kafka 和 RabbitMQ/RocketMQ 最核心的消费端差异——Kafka 的消费者对自己的消费进度负全责。如果消费者忘记提交 offset,重启后就会从上次提交的位置重新消费,产生重复消息。 二、Offset 提交机制 2.1 自动提交 vs 手动提交 Kafka 提供了两种 Offset 提交方式: 提交方式 配置 行为 风险 自动提交 enable-auto-commit: true 每隔 auto.commit.interval.ms(默认 5s)自动提交 poll 返回的最大 offset 消息可能没处理完就提交了——进程挂了会丢消息 手动提交 enable-auto-commit: false + ack-mode: manual 消费者处理完消息后显式调用 ack.acknowledge() 消息可能处理完了但没提交——重启后重复消费 flowchart TD classDef startEnd fill:#701a4c,stroke:#e11d48,stroke-width:2px,color:#fce7f3,font-weight:bold; classDef condition fill:#2a1147,stroke:#a855f7,stroke-width:1.5px,color:#ede9fe,font-weight:bold; classDef process fill:#1e1e24,stroke:#6b7280,stroke-width:1.5px,color:#e5e7eb; classDef highlight fill:#450a0a,stroke:#dc2626,stroke-width:1.5px,color:#fecaca,font-weight:bold; POLL([poll 拉取消息]) --> PROCESS[处理消息] PROCESS --> MODE{提交模式} MODE -- "自动提交" --> AUTO["每隔 auto.commit.interval.ms\n自动提交最后一次 poll 的 offset"] MODE -- "手动提交" --> MANUAL["业务处理成功后\n显式调用 ack.acknowledge()"] AUTO --> RISK1["风险:消息还没处理完\n但 offset 已提交\n→ 进程挂了丢消息"] MANUAL --> RISK2["风险:消息已处理完\n但 offset 没提交\n→ 重启后重复消费"] class POLL startEnd; class MODE condition; class AUTO,MANUAL highlight; class RISK1,RISK2 process; 手动提交比自动提交更安全——至少你知道什么时候提交了。消息重复消费可以用幂等解决,但消息丢失无法恢复。 ...

十一月 16, 2022 · 6 分钟 · 1173 字 · yaomingye

Kafka Producer 深入:分区、ACK 与幂等

Kafka Producer 深入 📖 前置阅读:本文假设读者已掌握 SpringBoot Kafka 的基本发送操作(KafkaTemplate.send)。如果还不熟悉,建议先阅读 SpringBoot Kafka 全操作指南。 一、⚡ 问题切入:消息到底发到了哪个 Partition? 上一篇用 kafkaTemplate.send("order-topic", key, msg) 发送消息时,生产者背后发生了三件事: Partitioner 决定消息进入哪个 Partition 消息攒批——在内存 Buffer 中等待 batch.size 或 linger.ms 条件触发 根据 acks 配置决定什么时候认为发送成功 当你看到日志里 partition=1, offset=0 时,背后是这三个步骤的协作。每个步骤都有配置项可以调整——它们直接影响消息顺序、可靠性、吞吐量。 二、分区策略 —— 消息路由的第一个环节 2.1 默认分区策略 Kafka Producer 的 Partitioner 接口决定了每条消息进入哪个 Partition。默认实现是 DefaultPartitioner: // DefaultPartitioner 的逻辑(简化版) public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) { int numPartitions = cluster.partitionsForTopic(topic).size(); if (keyBytes == null) { // Key 为 null → 使用 Sticky 分区(粘性分区) // 不是轮询!是把一批消息都发到同一个 Partition,等 batch 满了才换下一个 return stickyPartition(topic, numPartitions); } else { // Key 不为 null → 用 murmur2 哈希 % Partition 数量 return Utils.murmur2(keyBytes) % numPartitions; } } 规则一:Key 为 null → Sticky Partition。Kafka 2.4 之前是轮询(Round Robin——每条消息换一个 Partition),2.4+ 改为 Sticky——把一批消息"粘"在同一个 Partition 上,等这个 Batch 满了或时间到了才切到下一个 Partition。这减少了网络请求次数——把同一批的消息打成一个请求发给同一个 Broker。 ...

十一月 15, 2022 · 6 分钟 · 1274 字 · yaomingye

Phaser 可重用动态线程同步屏障

Phaser 可重用动态线程同步屏障:双栈编排机制、64 位状态字与多阶段调度全解析 🤔 一、道格·李为什么需要比 CyclicBarrier 更灵活的屏障 CountDownLatch 和 CyclicBarrier 分别覆盖了两种同步场景:前者是"一个线程等 N 个线程完成",后者是"N 个线程彼此等到齐后一起走"。但道格·李在后续实践中发现了一个覆盖盲区:多阶段计算中,每阶段的参与者数量可能并不相同。 举个例子:分片计算一个大型数据集,第一阶段 8 个线程并行处理各自的分片;第二阶段某些分片的数据已经为空,对应的线程应该退出,剩下 5 个线程继续;第三阶段可能又加入 2 个新线程处理汇总结果。 CountDownLatch 做不到——它是一次性的,三个阶段需要三个实例。 CyclicBarrier 也做不到——它的 parties 数量在构造时固定,运行期间不能增删参与者。如果有线程中途退出,CyclicBarrier 会永远等不到第 N 个线程而永久阻塞(或者触发 BrokenBarrierException)。 道格·李因此在 Java 7 引入了 Phaser:一个支持动态参与者数量 + 多阶段循环使用的同步屏障。线程可以在运行时通过 register() 加入、通过 arriveAndDeregister() 退出,Phaser 自动调整每轮的等待计数。内部用一个 64 位的 state 字段打包了阶段号、已到达计数、未到达计数等所有状态信息,通过 CAS 无锁操作更新——这是 JUC 中最复杂的一个状态字设计。 🎚️ 二、Phaser 核心概念(术语定义) 在深入源码前,先明确几个关键术语: 术语 定义 类比理解 Phase(阶段号) 从 0 开始递增的整数,每轮同步完成后 +1 表示"第几轮同步" Party(参与者) 注册到 Phaser 中的一个线程/任务 需要等待的对象 Unarrived(未到达数) 当前阶段尚未调用 arrive() 的参与者数量 每到达一个就减 1 Arrive(到达) 线程调用 arrive() 表示完成当前阶段工作 通知 Phaser"我到了" Advance(推进) 当 unarrived 归零时,phase 自增,进入下一轮 所有人都到了,开始下一阶段 Register(注册) 增加一个参与者(parties + 1, unarrived + 1) 动态加入 Deregister(注销) 减少一个参与者(parties - 1, unarrived - 1) 动态退出 Termination(终止) Phaser 进入终止态,所有操作立即返回负数 强制结束,不再同步 🏗️ 三、数据结构展开 🔢 3.1 64 位状态字:所有信息的原子载体 Phaser 没有使用 AQS,而是直接将全部状态压缩在一个 AtomicLong(字段名 state)中。这是理解 Phaser 的根基。 ...

九月 7, 2022 · 11 分钟 · 2232 字 · yaomingye

CyclicBarrier 可循环屏障

CyclicBarrier 可循环屏障:源码解析、代际机制与 CountDownLatch 对比全解析 🤔 一、道格·李为什么需要一个可循环的屏障 CountDownLatch 解决了一个问题:一个线程等待多个线程完成操作。但道格·李在设计 JSR 166 时意识到,还有一种更复杂的同步场景没有覆盖:多个线程彼此等待——所有线程都到达同一个"集合点"后,再一起继续往下走。这在分片并行计算中非常常见:N 个线程各算各的,算完之后需要"对表"(交叉校验、汇总),然后继续算下一阶段。 CountDownLatch 做不了这件事——它是一次性的,计数器归零后无法重置。而且它的语义是"一个线程等 N 个线程",不是"N 个线程彼此等"。 Thread.join() 也做不了——join() 等的是线程终止,不是线程到达某个执行点。如果线程需要继续执行(而不是终止),join() 完全不对路。 道格·李因此设计了 CyclicBarrier:一组线程各自执行到某个"屏障点"后调用 await(),先到的线程阻塞等待,直到最后一个线程也到达屏障,所有线程同时被唤醒,继续往下执行。屏障打开后自动重置,可以用于下一个阶段——这就是 Cyclic(可循环)的含义。 与 CountDownLatch 的核心设计区别: CountDownLatch:外部协调者等待 N 个工人完成任务(一次性,一个等 N 个) CyclicBarrier:N 个工人彼此等到齐后一起行动(可循环,N 个彼此等) 🔄 二、数据结构展开:CyclicBarrier 的六大核心字段 📌 2.1 字段总览 // java.util.concurrent.CyclicBarrier public class CyclicBarrier { private final ReentrantLock lock = new ReentrantLock(); // ① 锁 private final Condition trip = lock.newCondition(); // ② 条件队列 private final int parties; // ③ 参与方总数 private final Runnable barrierCommand; // ④ 屏障动作 private Generation generation = new Generation(); // ⑤ 当前代际 private int count; // ⑥ 倒计数 // 内部类——代际 private static class Generation { Generation() {} // 默认 broken = false boolean broken; // 当前代是否被打破 } } 用一张结构图展示这些字段之间的关系: ...

九月 5, 2022 · 10 分钟 · 1922 字 · yaomingye
Cat Radio